综合 / 人工智能 · 2026-10-27 09:10 · 1 阅读 · 0 赞
StreamEval:首个开源实时交互视频模型评测榜单
StreamEval 是首个开源的实时交互视频模型评测榜单,覆盖数字人、世界模型、实时视频编辑等五类任务,提供完整测试流程与开源数据,从任务执行度、状态一致性等四个维度评估模型表现。
实时交互视频模型现在很火,数字人、世界模型、实时视频编辑模型都是。但真实使用上效果如何?纯测几个case可能不够全面,也不够系统化。实时交互模型想系统测试比较麻烦,比如连续修改几次、提多次要求后,要看动作和编辑指令是否完成、画面场景是否连续、画质是否与参考图一致等等。
前天晚上,正好刷到了首个开源的实时交互视频模型榜单——StreamEval,分享给大家。项目的参与者来自清华大学、英伟达、普林斯顿、UC Berkeley 等海内外高校和机构。
StreamEval不光开源了一整套的测试流程,还把测试数据也开源了出来。
Github:https://github.com/StreamEval/StreamEval
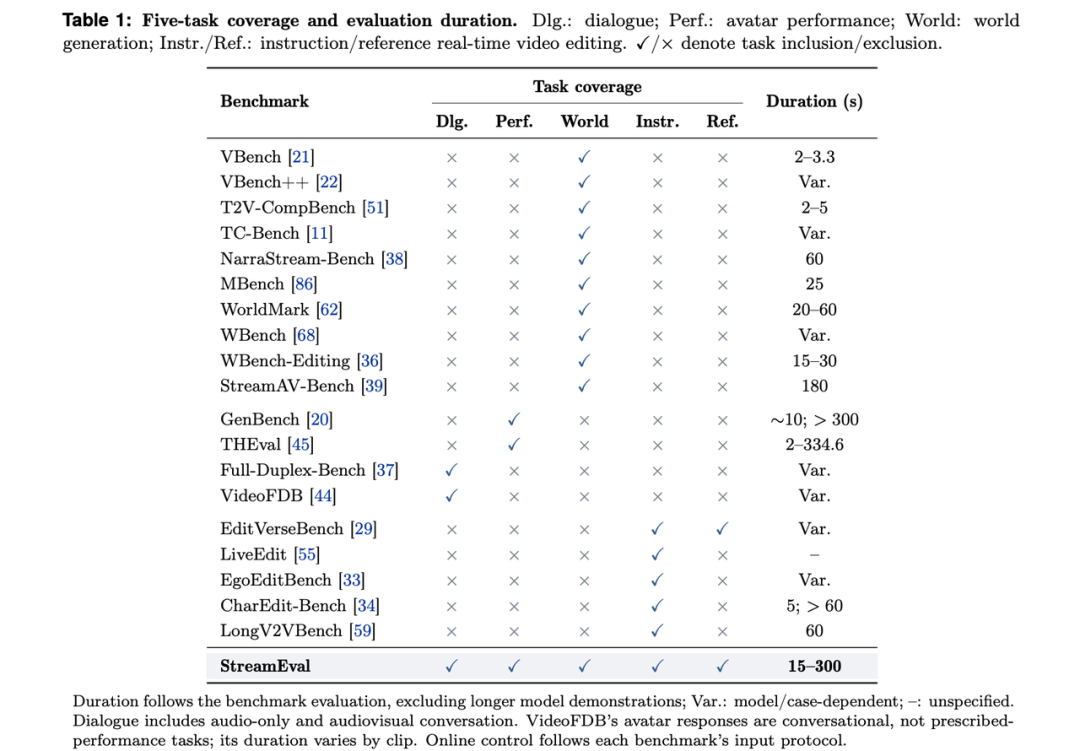
现在也有很多其他的benchmark,但仔细看下来,都没有这个StreamEval全。它一共涉及了5类实时交互视频模型,包括数字人对话和表演类模型、世界生成模型、文字和参考图驱动的实时视频编辑模型。如下表,其他大部分benchmark仅涉及一类,同时测试时长也比较单一。
StreamEval的五类任务,各有60个Case,每类中又有15、30、60、120、300秒五档,每档12个Case,一共300个Case。数据也覆盖了不同的使用条件,比如人物形象包括写实、3D、动漫和黏土等风格;对话有清晰语音,也有加入背景噪声和房间混响;视频编辑包含室内外场景,以及单个或多个编辑目标等。详细如下:
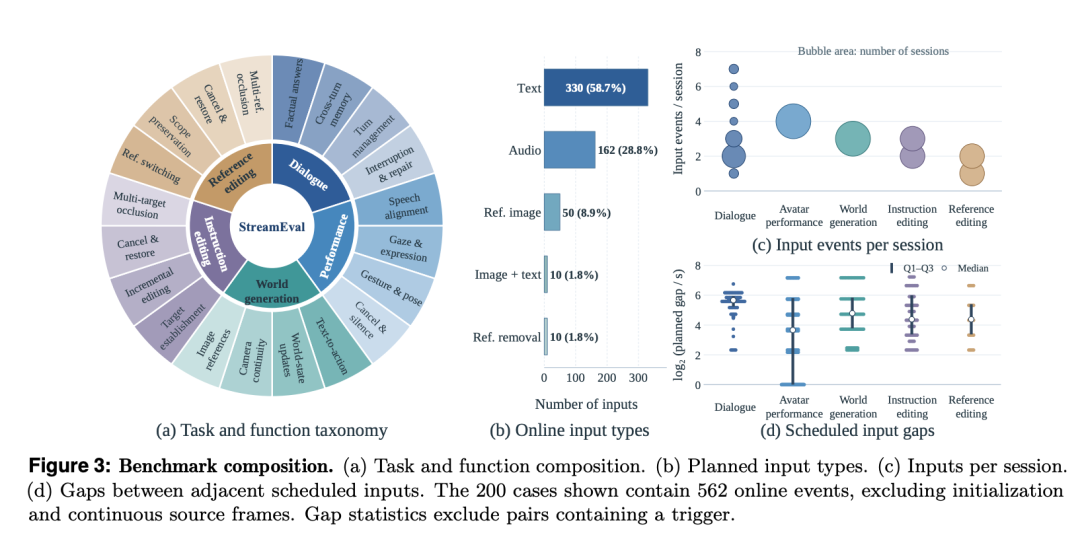
PS:评测时,五档时长的Case权重相同,每个Case独立运行三次取均值。
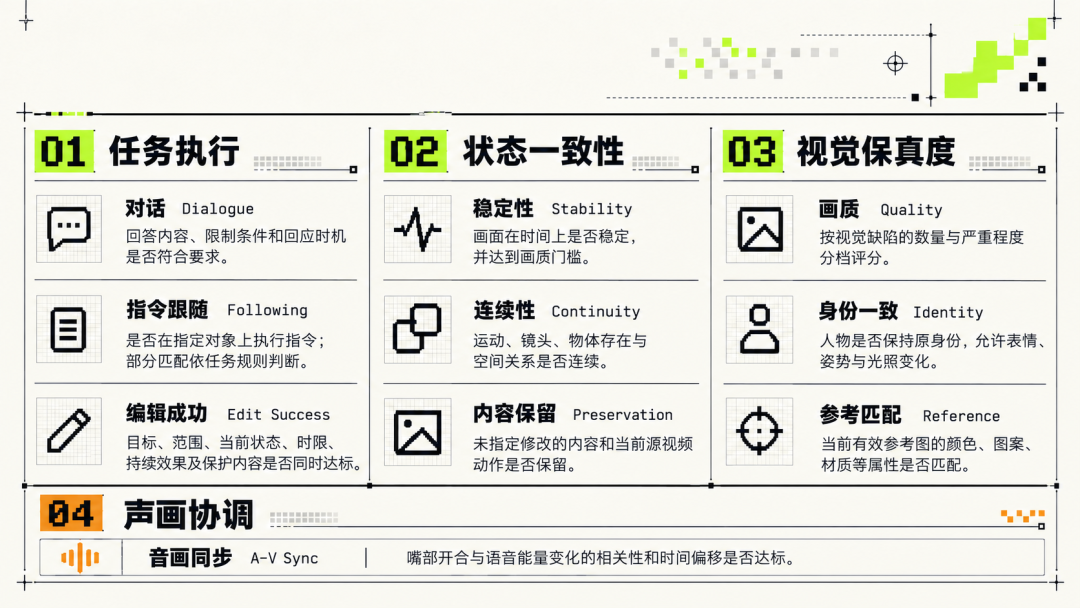
StreamEval在评测时,为确保公平权威性,主要从任务执行度、状态一致性、视觉保真度和声画协调度4个维度(10个指标)来进行评测:
- 任务执行度:检查对话是否满足要求、动作和编辑指令是否完成;
- 状态一致性:看画面是否稳定、场景是否连续,以及不该修改的内容是否保留;
- 视觉保真度:看画质、人物身份保持和参考图外观匹配;
- 音画协调度:检查口型与语音是否同步(A–V Sync)。
测试过程如下图所示,调度器会按照Case的时间线发送输入内容,并且源视频也跟着会话时间持续推进。整个过程中的输入内容、模型生成的视频和音频,以及对应的时间信息都会被记录下来。
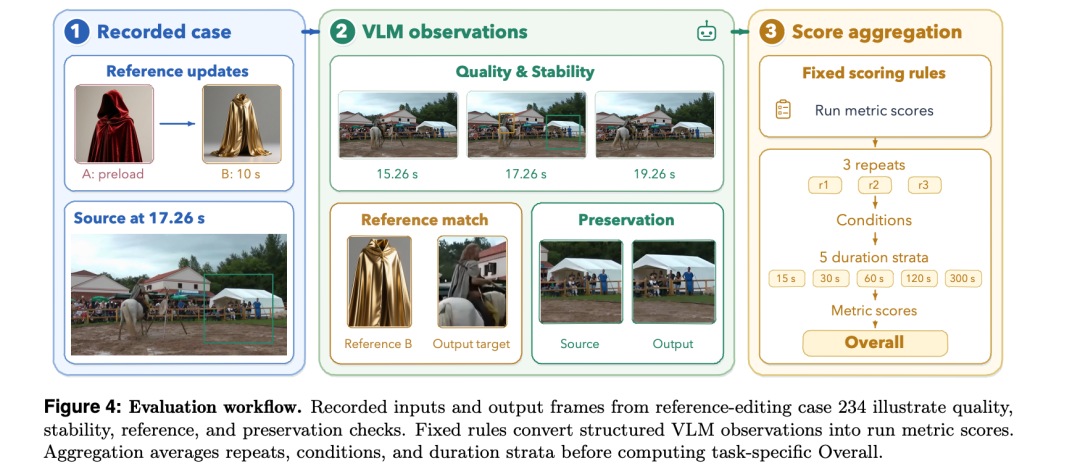
其中:
视觉检查由多模态模型裁判给出结构化观察,再由固定规则转成分数。画质以五秒片段为单位,按无缺陷、一个轻微缺陷、多个轻微缺陷、一个严重缺陷、多个严重缺陷,分别计为100、75、50、25、0分,严重缺陷优先判定。
人物身份会初始肖像与输出帧对比,由两个模型裁判分别判断,取较低评级;正常的表情、姿态和光照变化不会直接视为身份变化。参考图匹配检查当前生效参考图中的指定外观属性;内容保留检查未编辑区域及源视频运动;世界连续性则检查物体、镜头、转场和空间关系是否连贯。
音画同步比较嘴部开合与音频包络的相关性判断,规定语音事件的相关性至少为0.3,同时,系统汇总时延的95%置信区间须完全落在正负200毫秒内。
最终分数计算,是先平均同一案例的三次运行,再平均同一时长档内的案例,最后对五档时长等权平均。
那这些模型跑出来,效果怎么样?
可以看一下整体的榜单,这里就不详细介绍了。
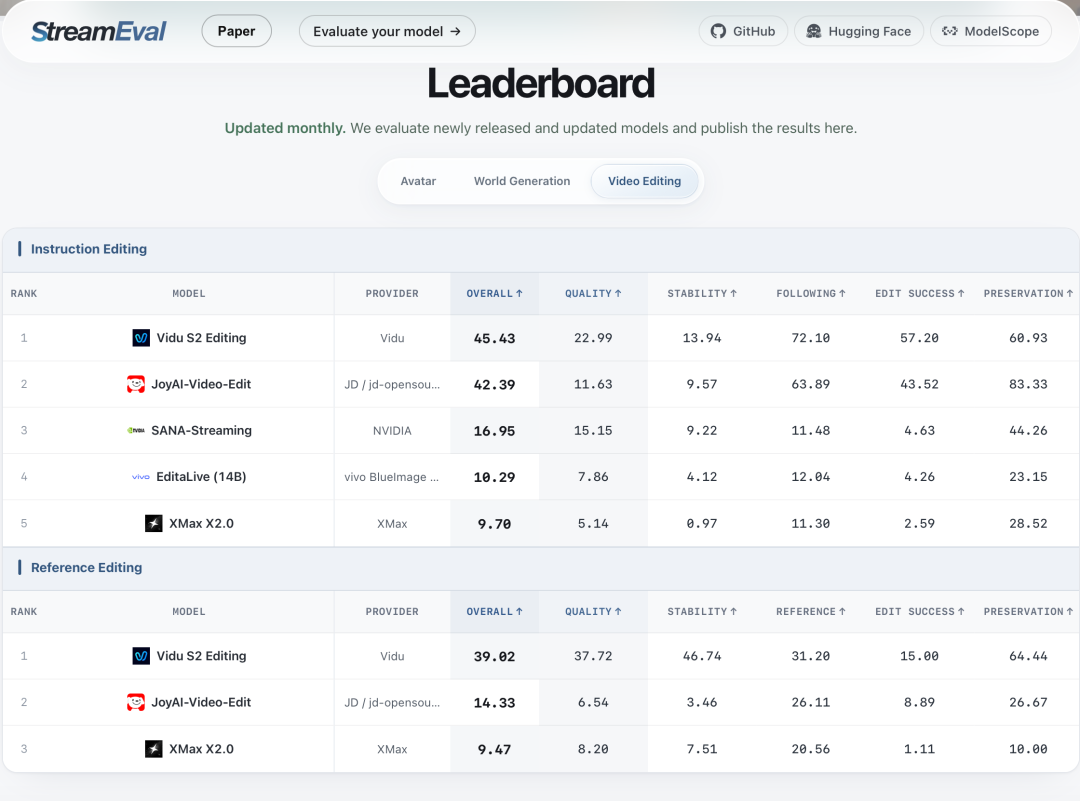
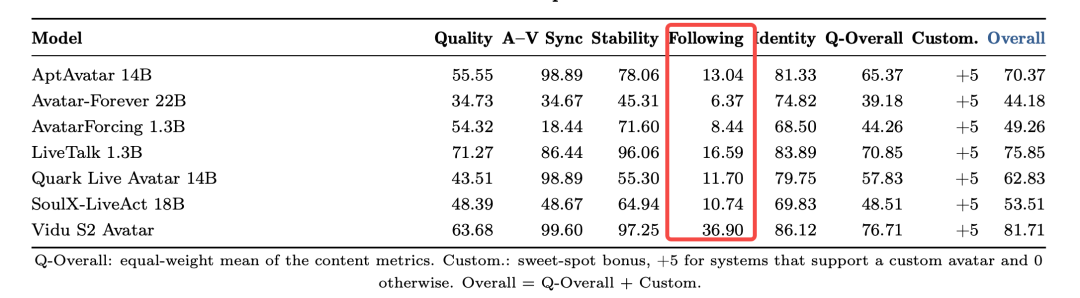
但有一点值得说:模型的画面表现与指令执行能力并不一致,Following的短板在数字人表演和世界生成中尤其明显。
比如,数字人表演中,7个模型有6个的Following低于20分,即使排名第一的Vidu S2 Avatar,Following也只有36.90分。LiveTalk在画质上最高,但Following却只有16.59分。
所以,人物能够稳定地说话、保持外观,到了按要求改变视线、表情或手势时,执行能力就明显跟不上。
世界生成模型、指令编辑模型也有类似问题:
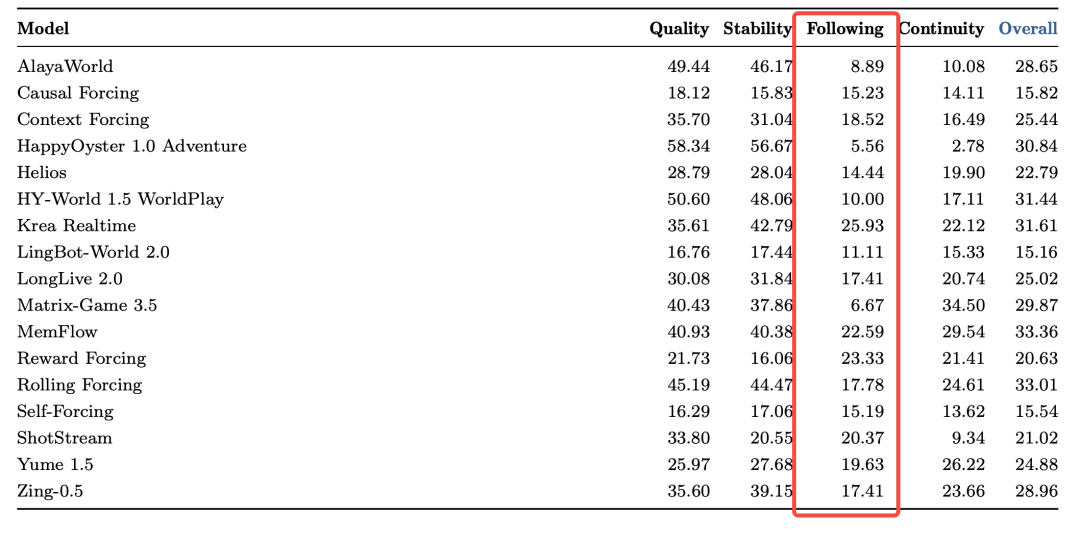
也就是,即使一开始画面看起来不错,但用户在生成过程中不断追加要求时,模型也未必能正确改变指定对象或场景。
StreamEval的交互测试题目主要是模型辅助构建的:
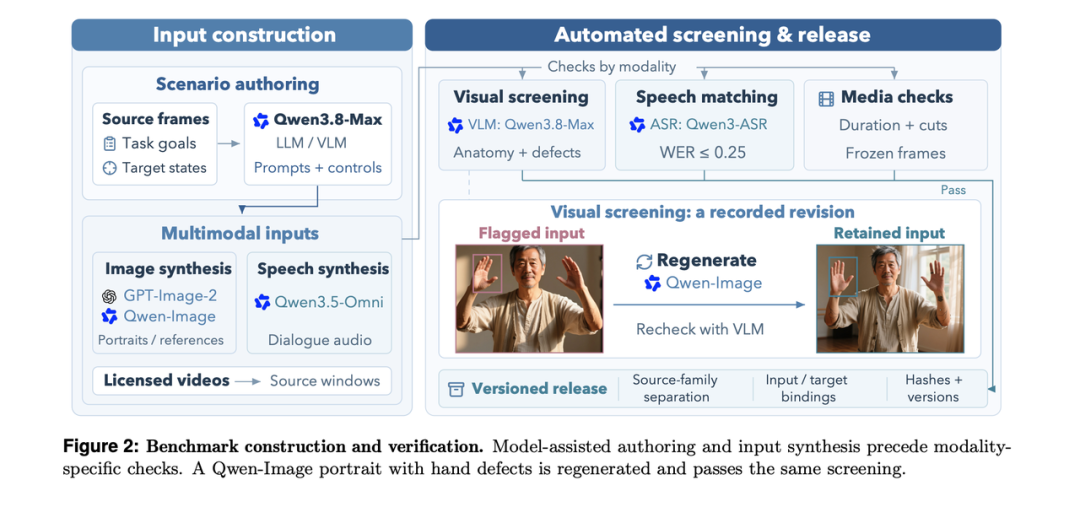
输入素材按任务分别准备,GPT-Image-2和Qwen-Image生成头像和视觉参考,人物采用原创合成的成年人或风格化虚构角色;Qwen3.5-Omni生成用户说话和数字人表演需要的语音;对话题还配有人设和核实过的事实,并加入背景噪声、房间混响等声音条件。
视频编辑使用的源素材,包括有许可的真实视频、动画和为benchmark生成的场景,第三方来源有Wikimedia Commons、NASA和Blender Studio,各素材附有对应的许可与署名信息。
素材准备好以后,还做了自检,核对文件能否正常解码、时长是否合适,以及输入事件与验收条件是否对应。语音用Qwen3-ASR转成文字,再与原始脚本比对,要求归一化词错误率不超过0.25;图像由Qwen3.8-Max检查主体是否清楚,有没有身体结构或渲染缺陷;编辑视频则检查场景切换、画面冻结,以及目标是否适合编辑。
详细数据如下:
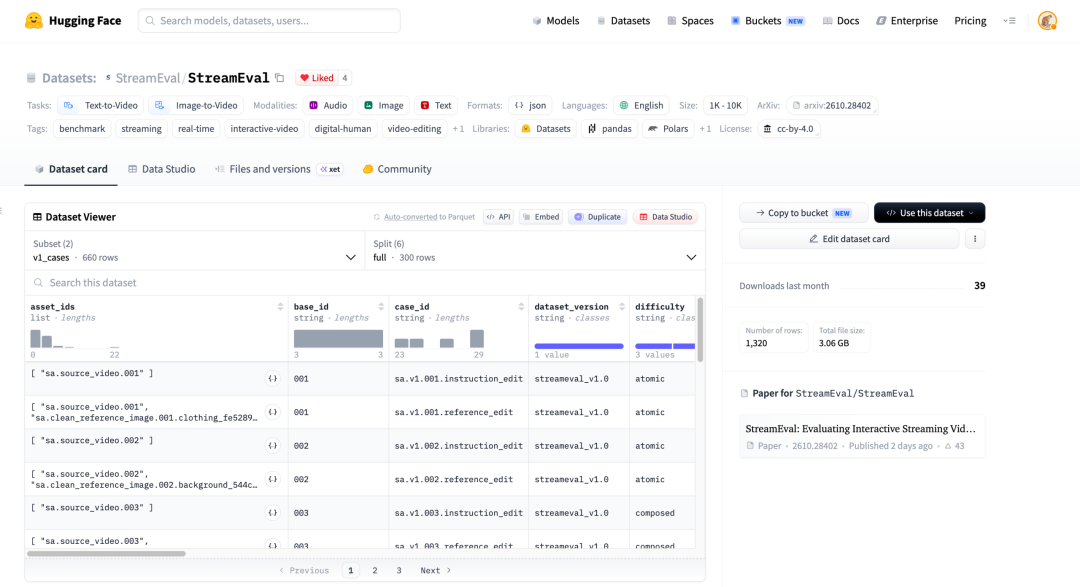
其实,StreamEval的价值不只是告诉你哪些模型更好。公开的测试数据、交互脚本、预期结果和评分工具,开发者可以接入自己的模型,检查分析模型具体存在哪些问题。
开源也让结果更透明、更容易验证,结论的可信度也有了可检查的依据。
同时人人都可以参与,StreamEval提供了一个“Evaluate your model”的评测申请入口,科研机构、企业模型团队和个人开发者均可在这里提交模型信息,你也可以是共建者。
对模型开发和产品选型都有帮助:开发者可以据此判断,一次模型更新究竟改善了画质,还是提高了指令执行和状态保持能力;做应用的团队则可以围绕自己的场景比较模型,比如需要数字人配合动作,就要重点看Following,做实时视频编辑,则需要一起检查修改是否完成、原有内容是否保住,以及画面能否持续稳定。
测试数据开源也确实会带来新的问题,后续训练可能会接触这些数据,也会有围绕Case的情况做针对性优化的情况。不过,GitHub项目上说数据会长期维护,同时StreamEval Team每月都会评测新增模型和更新后的模型,并公布最新测试结果,这就极大缓解了这个问题,也为StreamEval榜单带来了更高的应用价值。
看完这个benchmark,对视频实时交互模型的测试维度理解更加深刻了,感兴趣的大家可以去关注或者亲自参与一下。