综合 / 人工智能 · 2026-10-22 16:49 · 2 阅读 · 0 赞
Plus用户如何分配Astra、Sol与Luna:Codex三层模型分工实践
Astra额度变宽后,Plus用户不必再退回Sol。本文给出Astra啃硬活、Sol做收尾、Luna跑CI的分工方案,并说明推理档位、CLI版本、额度池共用等边界与注意事项。
作为 Plus 用户,你在 Codex 里其实一直能用 Astra,只是大部分人舍不得开。
舍不得是有道理的。Astra 刚上线那阵,我打开 ChatGPT 两次,每次用不到 10 分钟,5 小时额度就没了。我当时就判断,Astra 没打算给 Plus 用户用,只写代码的人先退回 Sol 更划算。
再后来 GPT-6 Sol 和 Luna 发布,情况变了。同样是 Plus,我现在开着 Astra 的中档或者高档,5 小时里能做的事情比以前多了一倍。以前只能跑 10 分钟,现在能跑 20 分钟。
所以该切换了。切换的意思是重新分一下工,Astra 啃硬活,Sol 做收尾,Luna 去跑测试。
今天就把这套分工讲清楚,顺便说一下模型怎么切。
Astra 的额度分配得更多了
这是个人感受,你不一定复现得了。官方的口径给的是范围。Plus 在 Codex 里,Astra 大约 5 到 45 条本地消息一个 5 小时窗口,Sol 是 15 到 150 条,Luna 是 350 到 3000 条。
为什么给范围不给条数,因为实际能发多少条,取决于任务大小、上下文长度和推理档位。同样一条消息,改一行 CSS 和重构一整个模块,消耗完全是两回事。
额度变宽的原因我没去考据,官方也没作解释。我的理解是,之前所有活都压在 Astra 一个模型上,现在多出两档可以分担,Astra 的额度自然就留给了真正需要它的地方。
这个理解不用较真。要紧的是结论,现在动手用 Astra 吧,毕竟开 Codex 就是为了用最好的模型。
Sol 的水平,国产模型也给得了
根据评测,GPT-6 Sol 也就相当于 GLM 5.3,用起来有什么意思。
这是我的个人体感,后来我翻了公开评测,发现它站得住。
Artificial Analysis 的智能指数上,GPT-6 Sol 的最高档是 47.5,GLM-5.3 是 44.8,三点之差。软件工程评测 DeepSWE v1.1 上,Sol 报的是 68.8%,GLM-5.3 报的是 66.9%,两点之差。这两个数字都是厂商自己报的,不是第三方复现出来的,所以只能当参考。但方向很清楚,这两个模型站在同一个台阶上。
而 GLM-5.3 是智谱开源的,三千多亿参数,上下文一百万,API 价格还比 Sol 低。换句话说,Sol 能给你的水平,一个开源的模型差不多也能给。
Sol 有自己的好处,这个公道话我得说。它快得多。公开的一次任务对比里,同一个任务 GPT-6 Sol 输出了 1850 个 token,GLM-5.3 输出了三万多,前者说完就收,后者像话痨。Sol 也更省 token,也就更省钱。
但这些好处都属于省钱省时间这一类,跟模型的台阶无关。台阶只有一级,就是 Astra 那一级。
你付的钱,买的是 Astra 这一档
我们算一下账。Plus 每个月 20 美元,Codex 和 ChatGPT Work 都能用。
“能写代码”这件事本身现在不值钱了,免费模型也能写,写得还不差。你花钱买的,是遇到难题时多出来的那段判断力。而在你的订阅里,这段判断力只对应一个模型,就是 Astra。
OpenAI 自己的定位也是这样。Astra 是它现在最好的模型,留给最难的推理和大型 agent 任务。Plus 用户在 Codex 和 ChatGPT Work 里能选到它,普通的聊天框里反而选不到。这个安排本身就说明,Astra 是付费才摸得到的那一档。
你花 20 美元,用着一个跟国产模型差不多水平的模型,然后看着 Astra 的额度一个窗口一个窗口地过期。这就是主力跑 Sol 的结果。
API 价格是这样的,每百万 token,Astra 输入 10 美元、输出 50 美元,Sol 是 2 和 10,Luna 是 0.1 和 0.5。Astra 是 Sol 的 5 倍价,Sol 又是 Luna 的 20 倍价。
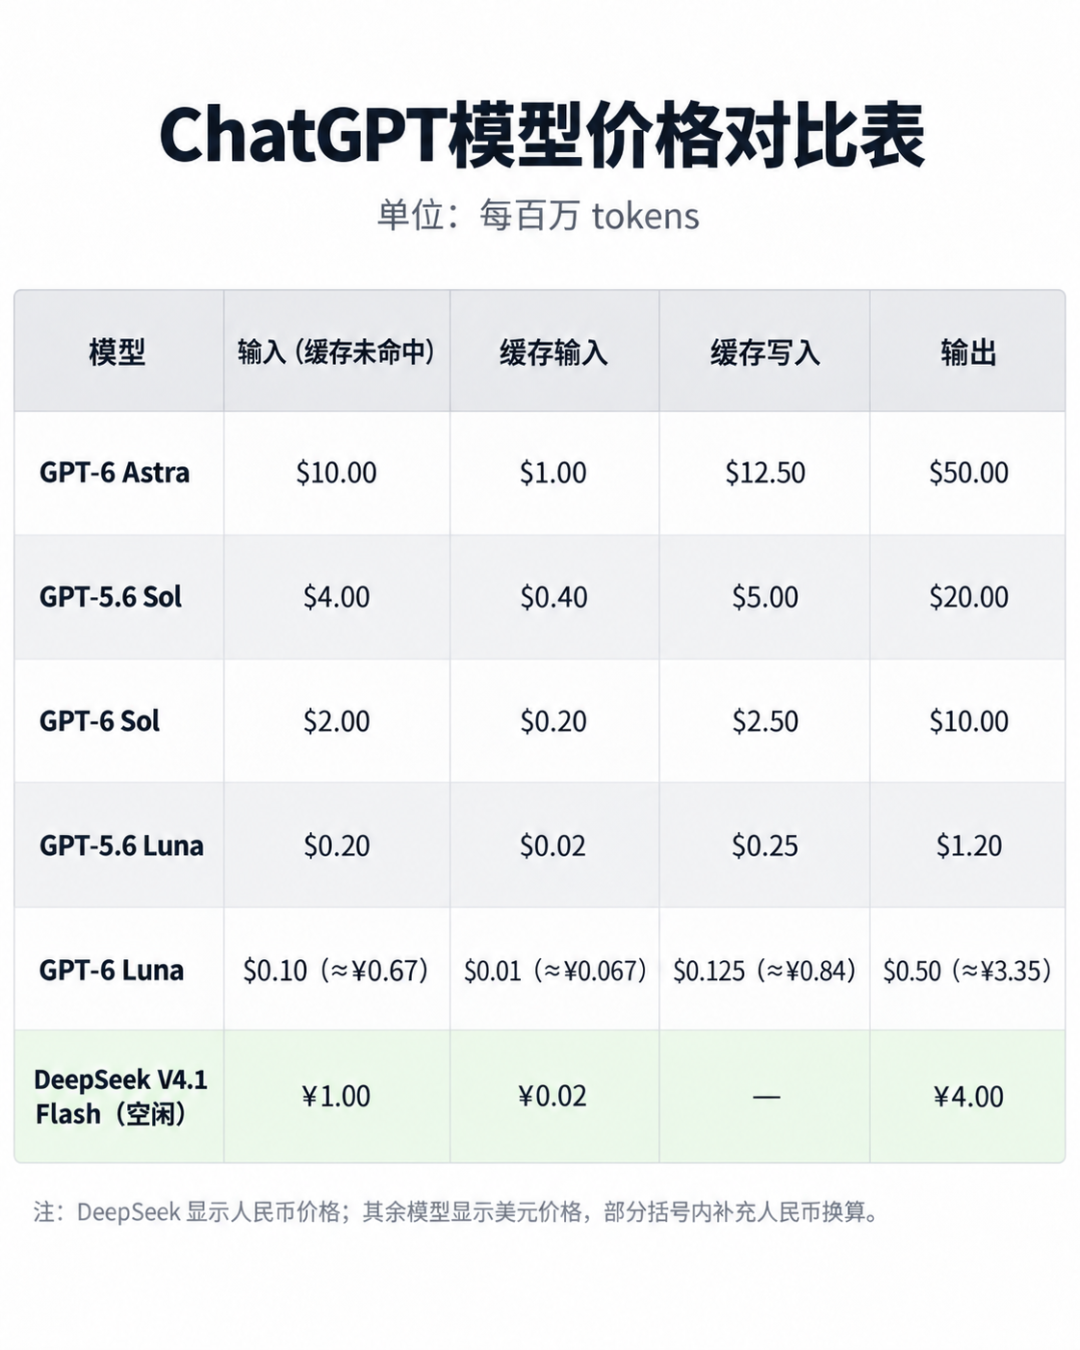
这个倍数关系就是分工的价格依据。你把 Astra 的额度花在收尾和跑测试上,等于用 5 倍的价格去干 1 倍的活。
三层分工:Astra 啃硬活,Sol 做收尾,Luna 跑测试
Astra 留给什么样的活
一句话说不清、需要它自己拆需求的任务。跨多个文件的改动。架构上的判断。端到端一次做完的活,从读代码到改代码到跑测试。要几个子代理协作、由主代理统筹的活。还有做错了代价很高的活,安全相关的、数据迁移、要对外发布的方案。
档位我日常用中档,碰到硬骨头往上调到高档或者超高。Astra 没有“不推理”这一档,最低从低档起步,它天然就是给需要动脑的活准备的。
Sol 只做收尾
收尾的意思是,主路径已经跑通了,目标也明确了,剩下的是按清单把活做完。比如改文案、补边界处理、把报错清干净、统一格式、提交之前再自检一遍。
这类活不需要重新判断方向,方向早就定了。但它也不能出错,收尾阶段出错最烦,你以为快完事了,结果又得回头。所以不能丢给最便宜的那一档。
Sol 正好卡在中间。它比 Astra 便宜 5 倍,额度宽 3 倍以上,看懂上下文的能力够用。价格便宜了这么多,同样的额度,能做的任务就翻倍了,这就是中间这一档的价值。
Luna 去跑 CI
CI 就是持续集成,代码提交上去之后自动跑的那套检查。它的特征是要跑很多次,而每次要做的事都很小,通过还是不通过由机器判定,用不上模型的判断力。跑错了重跑一次,成本也几乎为零。
这种活给 Luna 最合适。它比 Sol 便宜 20 倍,5 小时窗口里有 350 到 3000 条额度,你怎么跑都撞不到天花板。
这里有个细节要分清。CI 的配置第一次写的时候,别用 Luna。这活我试过,让 Grok 写,写出来有问题,换成 Astra 就没事了。写一份能跑起来的 CI 配置,是要判断力的活,交给 Astra 或者 Sol 来写。写好之后的日常反复运行、批量改格式、跑测试,才是 Luna 的主场。
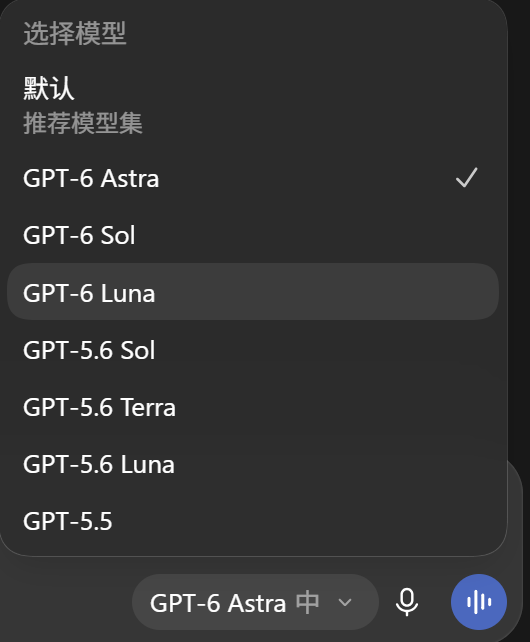
几个要提前知道的边界
Astra 不支持“不推理”这一档。如果你从旧模型切过来,推理档位还停在 none 或者 minimal,切到 Astra 会报错,从 low 开始试。
Codex CLI 的版本要够新,Astra 需要 0.153.0 或者更高。模型选择器里找不到 Astra,先检查版本更新。
Plus 在普通的 Chat 界面里选不到 GPT-6,要用 Work 或者 Codex。Chat 的额度和 Codex 的额度是分开算的,两边互不占用。
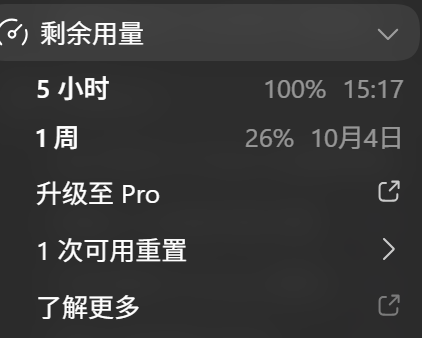
Codex 和 ChatGPT Work 共用一个额度池,两个口子计。一个是 5 小时滚动窗口,一个是周上限。所以在 Work 里用 Astra,一样是在花 Codex 的额度。
Sol 有个短板。有测试显示,遇到文档或者网页里藏着的指令,Sol 比 Luna 和 Astra 更容易照着做。所以让 agent 去读别人的网页、邮件、文件的时候,别用 Sol,或者至少把权限收紧。
同一个对话里换模型会清掉缓存,消耗会跟着上去。要换模型,新开一个对话更划算。
最后
这次就写这些。
如果你只是偶尔写点小脚本、改改配置,Astra 那段判断力你未必用得上,Sol 加 Luna 就够了。分工的意义是让对的活找对的模型,用满不等于用对。
花了钱就要用最好的模型,不然我花那钱干嘛,不如 150 充 DeepSeek,能用的 token 比起 Codex 不止一个量级,自己好好考虑一下吧。