综合 / 开发工具 · 2026-10-17 08:32 · 1 阅读 · 0 赞
GitHub 热榜项目 doldecomp/melee:把经典游戏《任天堂明星大乱斗 DX》拆回 C 源码
GitHub 上的 doldecomp/melee 项目尝试通过反编译与二进制匹配,还原 GameCube 经典格斗游戏《任天堂明星大乱斗 DX》的 C 源码,让隐藏的代码重新可读、可研究、可修改。
如果给你一个二十多年前的游戏,你能不能把它重新变成 C 源代码,再编译出与原版一致的程序?
这听起来像是不可能完成的任务。
但 GitHub 上的 doldecomp/melee,正在尝试完成这件事。
它的目标是还原任天堂 GameCube 平台上的经典格斗游戏《Super Smash Bros. Melee》(《任天堂明星大乱斗 DX》),通过反编译与逐步验证,让原本隐藏在二进制程序中的代码重新变得可读、可研究、可修改。
它不是一个普通的游戏复刻项目。
它真正有意思的地方,是试图回答一个底层开发者一直感兴趣的问题:没有原始源码,我们能否重新构建出原来的程序?
一、这个项目究竟在做什么?
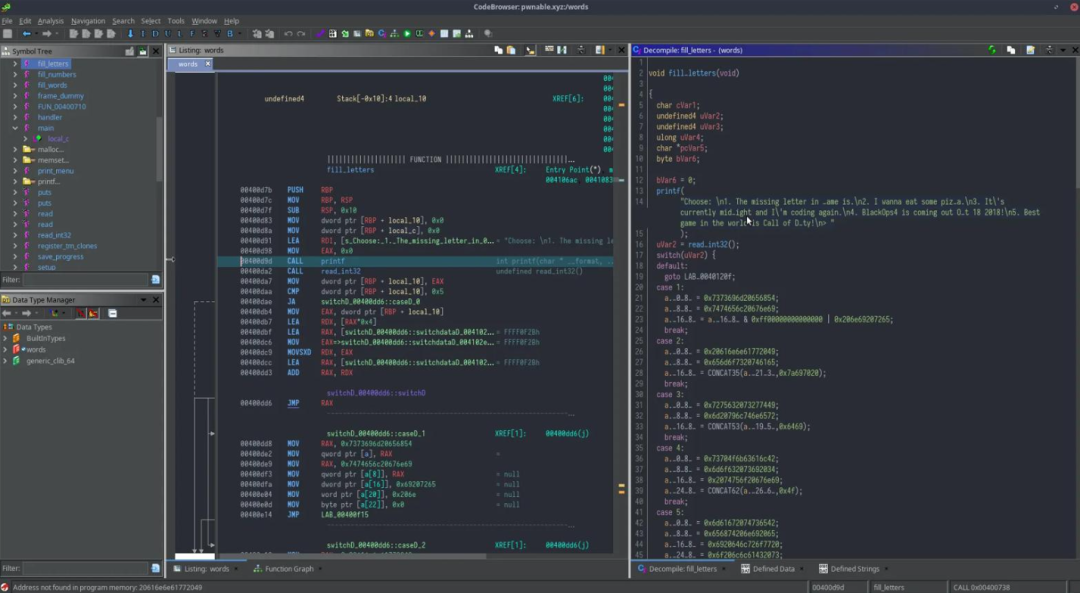
项目地址:
https://github.com/doldecomp/melee
先说一个关键概念:反编译。
我们平时写 C 代码,大致经历这样的过程:
C 源代码
   ↓
编译器
   ↓
汇编代码
   ↓
机器指令
   ↓
可执行程序
编译完成后,源代码中的变量名、函数结构、注释以及许多高级语言信息,都可能不再保留。
如果只有最终的二进制程序,想重新得到原始 C 代码,就会遇到很大的困难。
反编译工具可以尝试恢复程序的结构,但恢复出来的代码通常不等于原始源码,也不一定能够直接编译。
doldecomp/melee 走的是一条更严格的路线:不仅要让代码能够编译,还要努力让重新编译出来的程序与指定版本的原始程序在二进制层面匹配。
这就是它最值得研究的地方。
二、为什么还原源码比想象中困难?
很多人可能觉得,只要把机器指令反编译成 C,再编译一次就行了。
实际情况远没有这么简单。
1. 反编译出来的 C,不一定能生成相同的机器码
假设原始程序中有这样一个函数:
int calculate(int a, int b){
    return a * 3 + b;
}
即使反编译工具成功恢复了类似的代码,也不代表重新编译后会得到相同的机器指令。
不同的变量类型、表达式写法、编译器版本、优化选项,甚至寄存器分配方式,都可能改变最终结果。
因此,项目的难点不仅是理解程序的功能,还包括尽可能复现原始编译结果。
2. 编译器本身也是研究对象
同一段 C 代码,在不同编译器或不同优化设置下,可能生成完全不同的汇编。
即使两份程序在运行结果上完全相同,它们的二进制内容也可能存在差异。
这意味着开发者需要反复检查:
- 函数的汇编指令是否匹配;
- 数据布局和内存偏移是否正确;
- 结构体与变量的类型是否合理;
- 编译器生成的代码是否与目标版本一致。
有时候,修改一个看似无关紧要的表达式,就可能影响最终的机器码。
这也是为什么精确还原项目往往需要大量细致的工程工作。
三、这个项目不是只靠反编译器
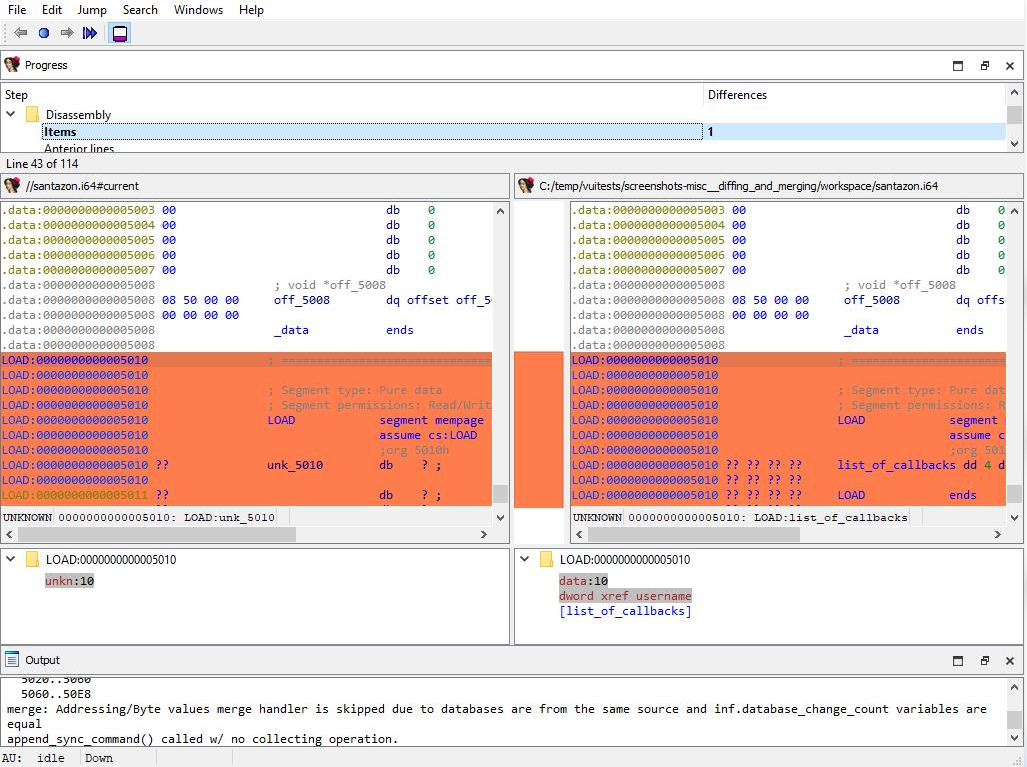
从仓库的构建说明来看,项目围绕指定的游戏版本组织源码、配置和构建工具。
它能够构建出对应的 main.dol 文件,并通过匹配构建流程验证结果。
仓库还提供了用于辅助反编译的工具,例如 decomp.py,可以帮助开发者针对特定函数开展工作。
整个过程可以概括为:
原始程序
   ↓
分析二进制与汇编
   ↓
编写或修正 C 源代码
   ↓
使用指定工具链编译
   ↓
对比生成的二进制
   ↓
定位差异并继续修正
这里有一个值得注意的细节:程序能够正常运行,并不意味着它已经被精确还原。
普通的软件开发通常更关注功能、性能和稳定性,而匹配反编译项目还需要关注生成结果与目标二进制之间的差异。
这是一种完全不同的工程目标。
四、为什么选择 C 语言?
这个项目并不是单纯为了证明 C 语言可以写游戏。
它与早期主机游戏的开发方式、底层运行环境和编译工具链都有直接关系。
在这类项目中,C 语言具有几个明显的特点。
第一,代码与机器行为之间的距离比较近。
指针、内存布局、结构体、整数宽度和调用约定等因素,都可能影响程序最终的行为和编译结果。
第二,容易研究底层数据结构。
开发者可以围绕函数、全局变量、内存地址和数据布局逐步建立对程序的理解。
第三,可以深入研究编译器行为。
当源码看起来正确,但编译结果始终不匹配时,问题可能出在表达式、类型推导、优化策略或寄存器分配上。
对于希望深入理解 C 语言、汇编和编译器的人来说,这类项目比单纯阅读算法示例更接近真实的底层工程。
五、普通开发者能从中学到什么?
即使你不研究游戏,也能从这个项目中获得不少启发。
1. 学习如何阅读陌生的大型 C 项目
项目源码包含游戏逻辑及相关运行时模块。你可以尝试从一个具体函数入手,逐步理解它的调用关系,而不是一开始就阅读整个代码库。
2. 理解 C 语言与汇编之间的关系
选取一个简单函数,观察 C 代码、汇编输出和最终二进制之间的对应关系,可以帮助你理解编译器究竟做了什么。
3. 学习自动化构建与差异验证
这个项目将配置、构建和结果比较纳入开发流程。
这种思路并不局限于游戏。固件分析、编译器测试、兼容性验证以及软件考古,都可能用到类似的方法。
4. 理解大型工程如何逐步推进
面对无法一次性解决的问题,开发者可以将工作拆分成函数、模块和可验证的目标。
每次只解决一部分差异,再通过工具确认修改是否有效。
这也是大型底层工程非常重要的一种工作方式。
六、如何在本地尝试?
项目官方仓库提供了 Windows、macOS 和 Linux 环境下的构建说明。
仓库地址:
https://github.com/doldecomp/melee
在 Windows 环境中,官方说明推荐使用原生工具链,不要求必须使用 WSL 或 MSYS2。
基本流程如下:
git clone https://github.com/doldecomp/melee.git --depth=1
安装 Python 和 Ninja 等所需工具后,根据官方说明准备指定版本的游戏数据,再运行:
python configure.py
ninja
需要特别注意:克隆仓库本身并不足以完成完整构建。
项目要求使用对应版本的游戏数据,并按照仓库说明从合法持有的游戏副本中提取所需文件。具体依赖、工具版本和配置步骤,请以仓库当前 README 为准。
另外,构建成功不代表可以随意分发原游戏的数据或资源。研究、修改和发布相关成果时,应当遵守适用的法律规定及相关权利要求。
七、它真正值得关注的,不只是游戏
很多 GitHub 热门项目提供的是新的框架、新的工具,或者一种更简单的开发方式。
doldecomp/melee 展示的却是另一种技术路线:
当原始源码不可用时,开发者仍然可以通过二进制分析、代码重建和自动化验证,一步步恢复对软件的理解。
这种工作需要的不只是编程能力,还包括对编译器、汇编、内存布局和构建系统的深入认识。
当然,这不是适合所有人的项目。它的学习门槛比较高,构建过程也比普通 C 项目复杂。
但如果你对 C 语言、逆向工程、编译器或经典游戏的内部实现感兴趣,它绝对是一个值得深入研究的案例。
有时候,理解一个程序最好的方式,不是重新写一个,而是尝试把原来的那个程序重新还原出来。
项目地址:
https://github.com/doldecomp/melee
如果让你选择一个方向深入研究,你会更想研究 C 语言底层、编译器,还是游戏逆向工程?欢迎在评论区聊聊。