综合 / 开发工具 · 2026-10-13 17:21 · 2 阅读 · 0 赞
8GB显存实测跑MiniMax H3:720p带音频9分钟出片,完整部署步骤
用RTX 5060 8GB本地部署MiniMax H3,选量化模型加8步采样加速,720p 5秒带音频视频9分钟出片。本文整理5个模型文件清单、4处文件名修改对照和常见报错排查。
MiniMax H3 开放本地部署后,最常见的吐槽是:满血模型要 100 多 GB 显存,普通玩家想都别想。
好消息是开源没多久就出了不少衍生版本,社区已有多个轻量化版本,8GB 显卡完全可以拿来玩。于是我用自己那张 RTX 5060 8GB,把 MiniMax H3 的 ComfyUI 本地部署完整跑了一遍。结论是:完全能跑,不是卡成幻灯片那种,720p 5 秒音视频直出,9 分钟就能出一段。
空口无凭,先看视频。下面这条就是 9 分钟跑出来的成片,720p 5 秒、480p 10 秒,带声音,注意听,音轨也是模型生成的。
-
【720p 2x5s=10s 生成耗时 约 16min】
-
【420p 2x10s = 20s 生成耗时 约 16min】
-
【本地运行 ComfyUI 工作流演示】
MiniMax H3 能不能塞进 8GB 显存,核心就一条:别照抄官方默认配置。模型选量化版,采样走 8 步加速,下面把过程和踩过的坑全交代清楚。
为什么 8GB 显存能跑?
先说原理,不然你一定觉得我在编。
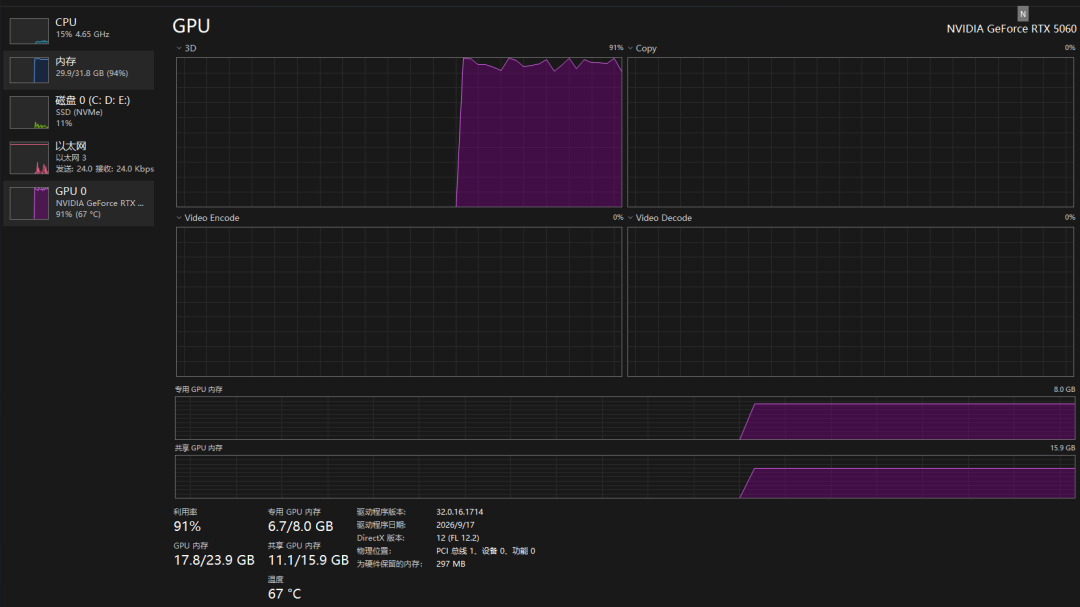
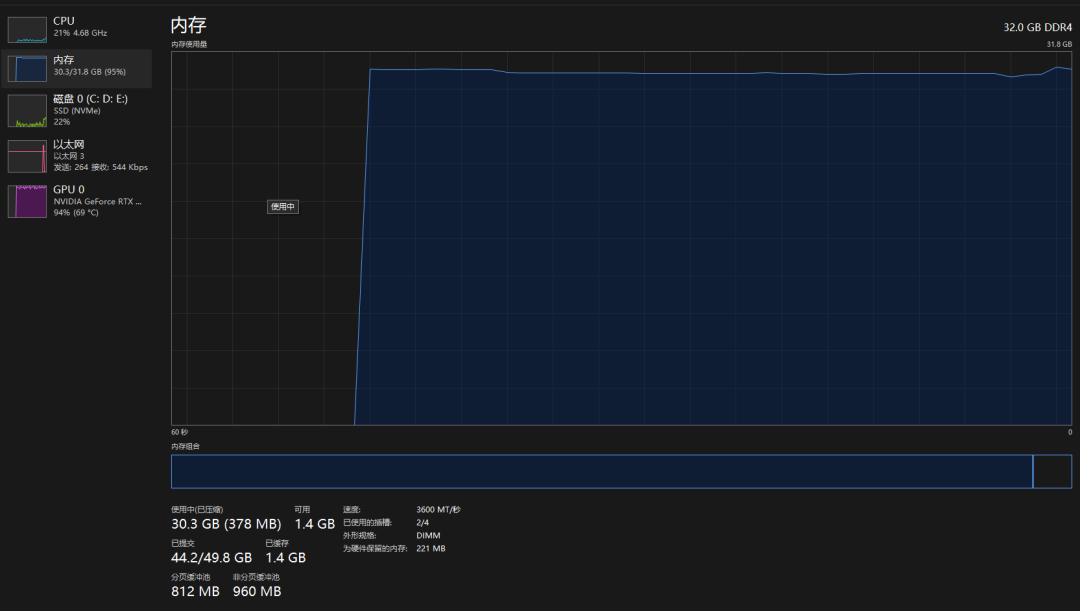
H3 全量 123GB,8GB 显存连零头都装不下,账确实没算错,但结论下早了。ComfyUI 会自动把模型权重在内存和显存之间来回流送,32GB 内存当仓库,8GB 显存当工作台,每次只把当前要算的那一层搬进显存,用完换下一层。代价就是慢,这事绕不开,内存 32GB 是底线,16GB 的机器先别折腾,会直接爆内存。
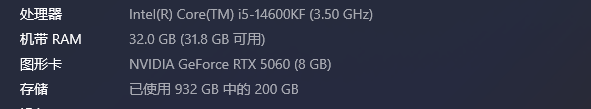
【猿人本地电脑配置】
慢怎么办,PDD Acc 补。采样步数从默认 20 步压到 8 步,蒸馏技术,画质损失极小,时间省一半以上。一个开源节点的事,装法后面说。
5 个轻量化模型文件缺一不可
版本下错,后面全白搭,先把清单列清楚,5 个文件总共 38GB:
| # | 文件 | 大小 | 放到哪 |
|---|---|---|---|
| 1 | minimax_h3_ref2va_pruned_int8_convrot | 19.5GB | models/diffusion_models/ |
| 2 | qwen3vl_32b_minimax_h3_nvfp4_awq | 14.6GB | models/text_encoders/ |
| 3 | minimax_h3_video_vae_int8_convrot | 2.8GB | models/vae/ |
| 4 | minimax_h3_audio_vae_fp32 | 0.6GB | models/vae/ |
| 5 | minimax_h3_ref2va_pdd_acc_8step_comfyui | 1.5GB | models/pdd_acc/ |
为什么是这几个版本,挨个来看看。
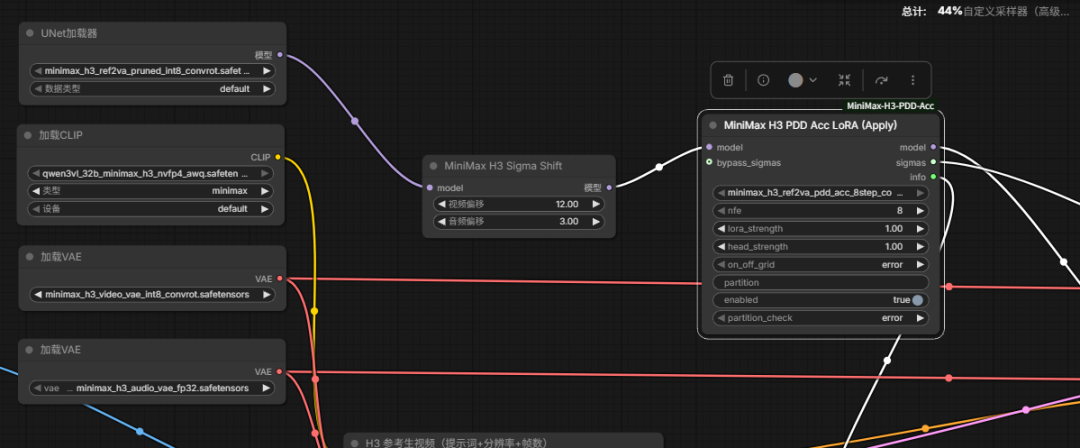
1. 主模型选 pruned_int8
不选 BF16。BF16 全量 61GB,标准 int8 也要 34GB,pruned 版剪掉 40% 调制权重压到 19.5GB,听着挺吓人,实测画质几乎无损。还有,Ref2VA 和 FL2VA 是两个分支,Ref2VA 支持参考图/参考视频/参考音频,FL2VA 是纯文生视频,做图生视频的选 Ref2VA。
2. 文本编码器选 NVFP4
50 系卡在这占便宜:48GB 的 BF16 不用想,25GB 的 INT8 还是太大,NVFP4 只要 14.6GB,Blackwell 架构原生支持,跑起来不降速。
3. 视频 VAE 选 int8
省下的 2GB 对 8GB 卡很关键。官方数据 67.7dB vs 68dB,人眼根本看不出区别。前提是 ComfyUI 得 v0.36.0 以上,旧版不认这个格式。
4. MiniMax 官仓下载
下载走 Comfy-Org/MiniMax-H3 仓库,用 curl.exe 加 -C - 参数断点续传,十几个 GB 的文件断了不用从头来。
部署只做两件事:装节点,改 4 个文件名
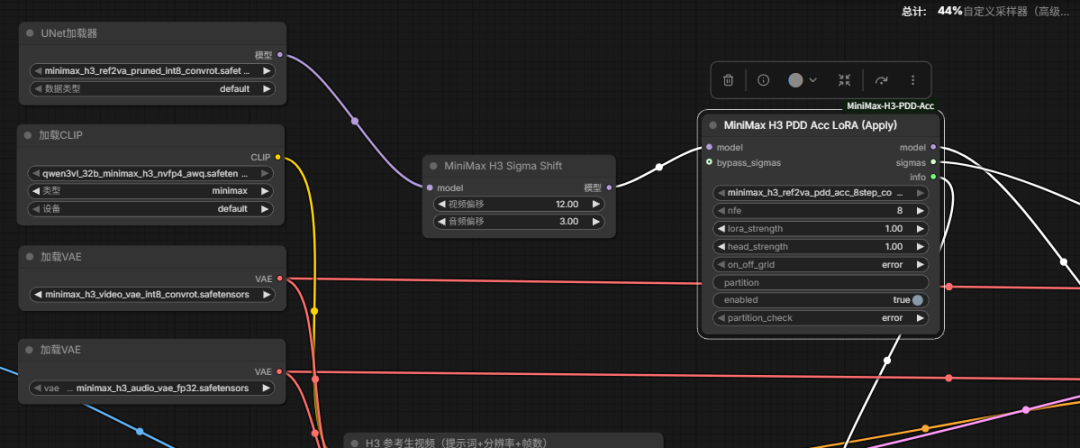
自定义节点装一个就够:ComfyUI-MiniMax-H3-PDD-Acc,进 custom_nodes 目录 git clone 一下,它是 8 步采样的关键。turbo、EasyCache 之类的加速 LoRA 别叠加,和 PDD Acc 冲突。
然后是我踩过最大的坑:节点自带的示例工作流,默认填的全是 BF16 文件名,你实际下的是量化版,不改直接报错。4 处修改对照表:
| 节点 | 默认值 | 改成 |
|---|---|---|
| UNETLoader | ref2va_bf16 | ref2va_pruned_int8_convrot |
| CLIPLoader | qwen3vl_bf16 | qwen3vl_nvfp4_awq |
| VAELoader | video_vae_fp16 | video_vae_int8_convrot |
| PDD Acc Apply | Ref2VA-Acc-8Step | ref2va_pdd_acc_8step_comfyui |
实测数据:720p 是 8GB 的甜点档
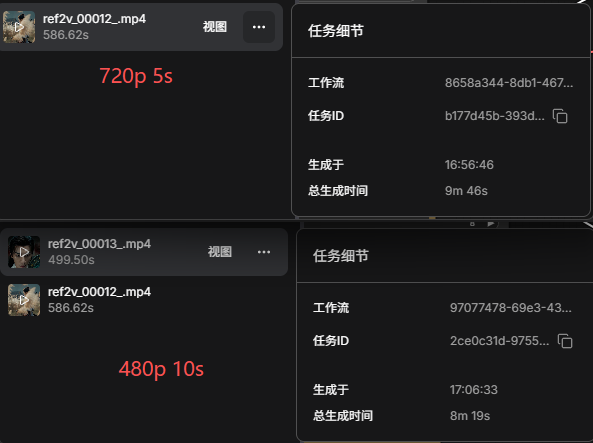
跑分直接上表,都是我这张 RTX 5060 实测出来的。有个心理预期先说,首次运行要先加载模型,另算几分钟,别掐着表等出片。
| 档位 | 分辨率 | 帧数(24fps) | 实测耗时 |
|---|---|---|---|
| 480p | 832×480 | 240 帧(10 秒) | 约 8 分钟 |
| 720p | 1280×720 | 124 帧(5 秒) | 9 分钟 |
| 1080p | 1920×1080 | 124 帧(5 秒) | OOM 爆显存 |
帧数换算记一下:帧数 ÷ 24 = 秒数,5 秒就是 124 帧。急着出片可以把 PDD Acc 节点的 nfe 从 8 改成 4,速度大约翻倍,我试过,画质确实会掉一点,日常还是 8 步为主。
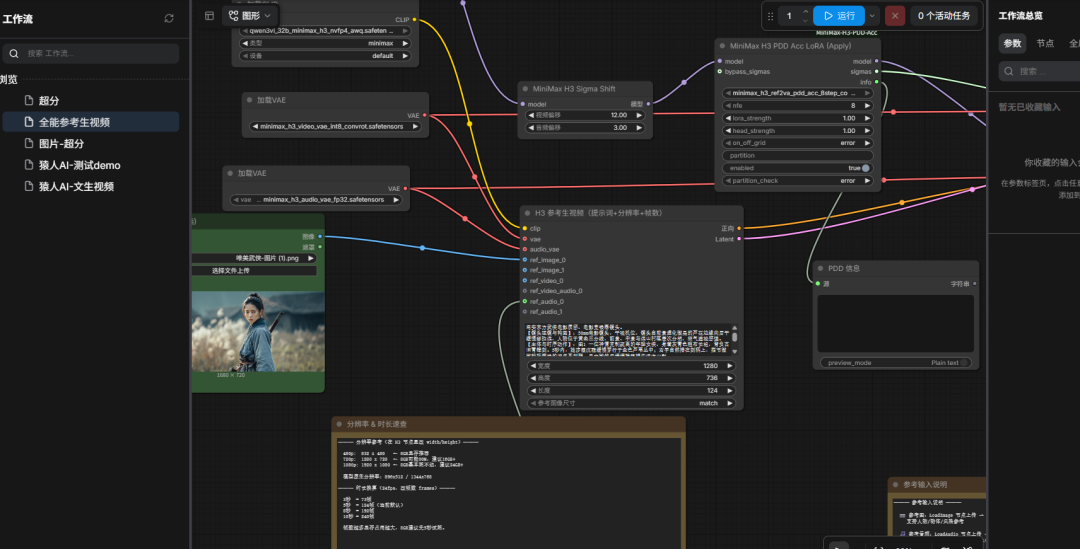
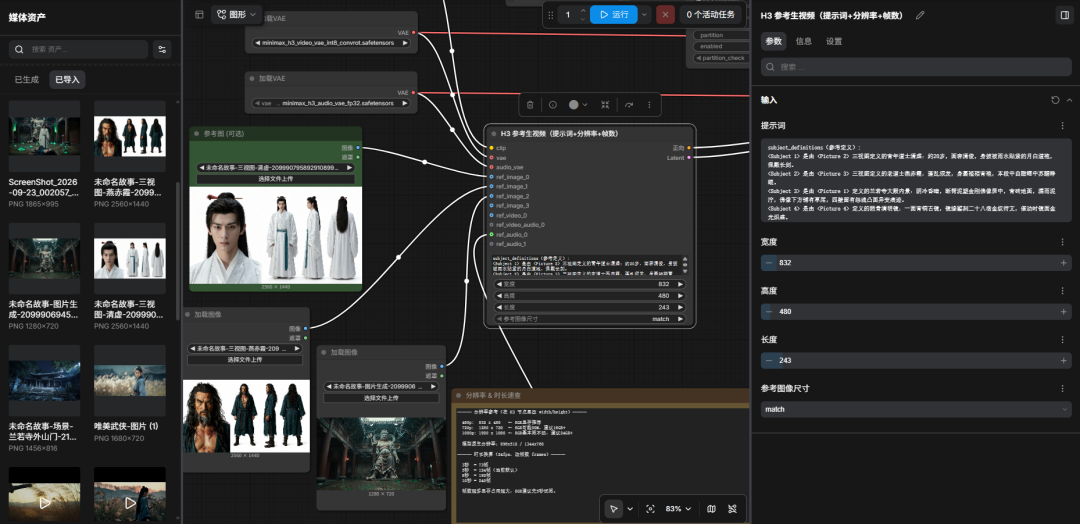
图生视频的接法:加一个 LoadImage 节点,输出接 ref_image_0,多图就右键加 ref_image_1。参考视频、参考音频同理,不过要多装一个 VideoHelperSuite 插件。但真正决定成败的是提示词写法,必须告诉模型每张图是干嘛用的,不说用途的参考图会被直接忽略:
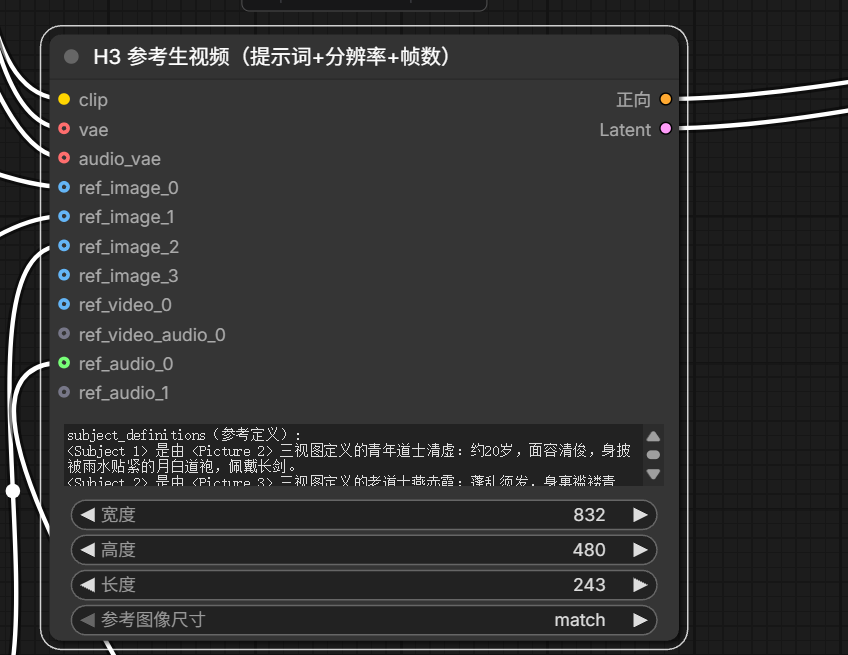
- subject_definitions(参考定义):
- <Subject 1> 是由 <Picture 2> 三视图定义的青年道士清虚:约20岁,面容清俊,身披被雨水贴紧的月白道袍,佩戴长剑。
- <Subject 2> 是由 <Picture 3> 三视图定义的老道士燕赤霞:蓬乱须发,身裹褴褛青袍,本段中自酣睡中苏醒睁眼。
- <Subject 3> 是由 <Picture 1> 定义的兰若寺大殿内景:阴冷昏暗,断臂泥塑金刚佛像居中,青砖地面,漏雨泥泞,佛像下方铺有草席,四壁留有怨魂凸面异变痕迹。
- <Subject 4> 是由 <Picture 4> 定义的照骨清明镜:一面青铜古镜,镜缘錾刻二十八宿金纹符文,催动时镜面金光炽盛。
3 个高频翻车点,我替你踩过了
跑起来很卡很慢?
正常,8GB 显存得在显存和内存之间来回搬权重。把浏览器和其他占内存的程序全关了,32GB 一点都别浪费在别的地方。
OOM 报错?
按顺序降:先降分辨率到 640×352,再砍帧数,还不行就先关音频只出视频。别一上来就 1080p,准爆。
视频没声音?
九成是没加载音频 VAE(minimax_h3_audio_vae_fp32),或者工作流里少了 VAEDecodeAudio 节点,查这两处。
PDD Acc 节点报错?
查三处:ComfyUI 版本得 ≥ v0.33.0,PDD 文件确认放在 models/pdd_acc/ 目录,还有主模型和 PDD 得都是 Ref2VA 版本,别和 FL2VA 混着用。
想加角色或风格 LoRA?
可以,放进 models/loras/ 目录,用 LoraLoaderModelOnly 节点接在 UNETLoader 后面就行。