综合 / 后端 · 2026-10-08 11:33 · 1 阅读 · 0 赞
GitHub 7.5 万星开源项目 MiroFish:用多 Agent 模拟推演未来走向
MiroFish 是一个基于多 Agent 的预测引擎,能把上传材料转成知识图谱并生成大量 Agent 进行模拟,输出预测报告与可交互的数字世界,适用于舆情分析、政策推演和故事创作。
我们平时刷到一条新闻,可能看过就划走了,但企业往往要继续追踪后续影响。
比如最近小米发布澎程 N70、N90,在汽车圈引发了不少讨论,很多车评人都做了点评。
如果某条视频突然冲上热榜,小米公关肯定想知道,接下来舆论会怎么发酵,哪些人和品牌会受到影响,讨论又会往哪个方向走。
以前遇到这种问题,通常要先搜集资料,再建模型、写报告,整个过程比较慢,也很依赖分析人员的经验。
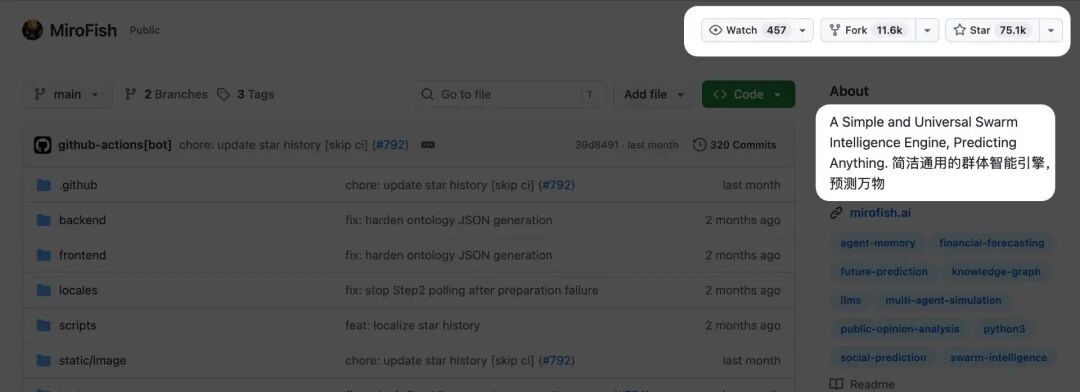
今天给大家推荐一个有点特别的开源项目 MiroFish,目前已经拿下 75.0k 星和 11.5k Fork。
它会把现实资料转换成一个可以运行的数字世界,再让成千上万个 Agent 在里面互动,帮助你观察事情接下来可能怎么发展。
不是问一次答案,而是先把未来演一遍
MiroFish 是一个基于多 Agent 技术的预测引擎。
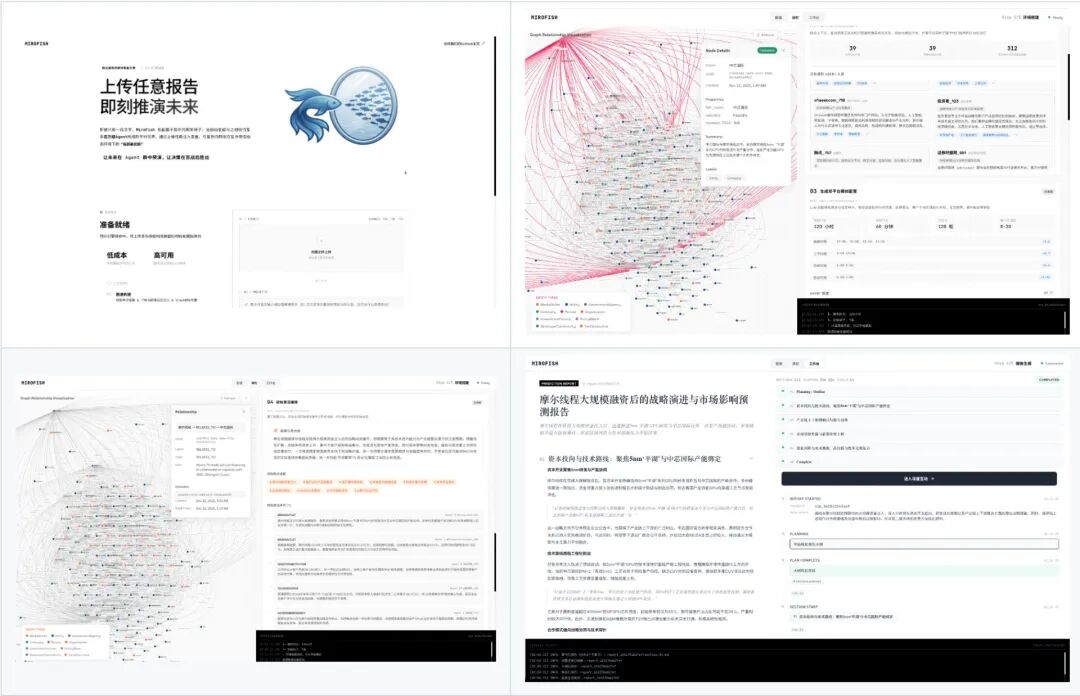
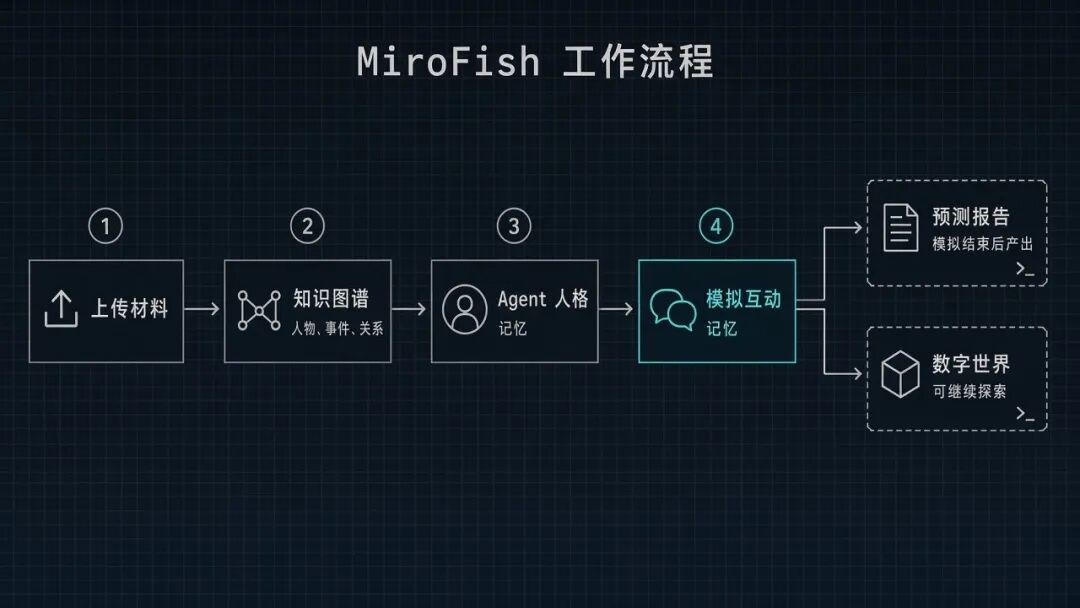
你上传一份材料,再用自然语言告诉它想预测什么。系统会从材料里提取人物、事件和关系,建立知识图谱,生成对应的 Agent 人格和记忆,然后开始模拟。
模拟结束后,你会拿到一份预测报告,以及一个可以继续探索的数字世界。
你可以从上帝视角加入新的变量,也可以直接和其中某个 Agent 对话,看看它为什么会做出这样的判断。
在线 Demo:
1
https://666ghj.github.io/mirofish-demo
从舆情事件到《红楼梦》续写,都能拿来试
仓库里已经放了几个演示案例。
一个是武汉大学相关舆情事件的模拟
另一个是根据《红楼梦》前八十回,推演可能的后续结局。
从这两个案例能看出,MiroFish 的应用范围挺宽。它可以分析现实中的公共事件,也能把小说、剧本和世界观设定变成一个可以互动的虚拟社会。
手里有行业报告、政策文本、竞品资料,甚至只有一个故事设定,都可以拿来试试。
不过,模拟结果始终取决于输入材料和模型本身,只能作为推演参考。材料越完整,人物关系和规则写得越清楚,结果才越值得参考。
它省掉了建模和推演中的重复劳动
先把材料整理成知识图谱
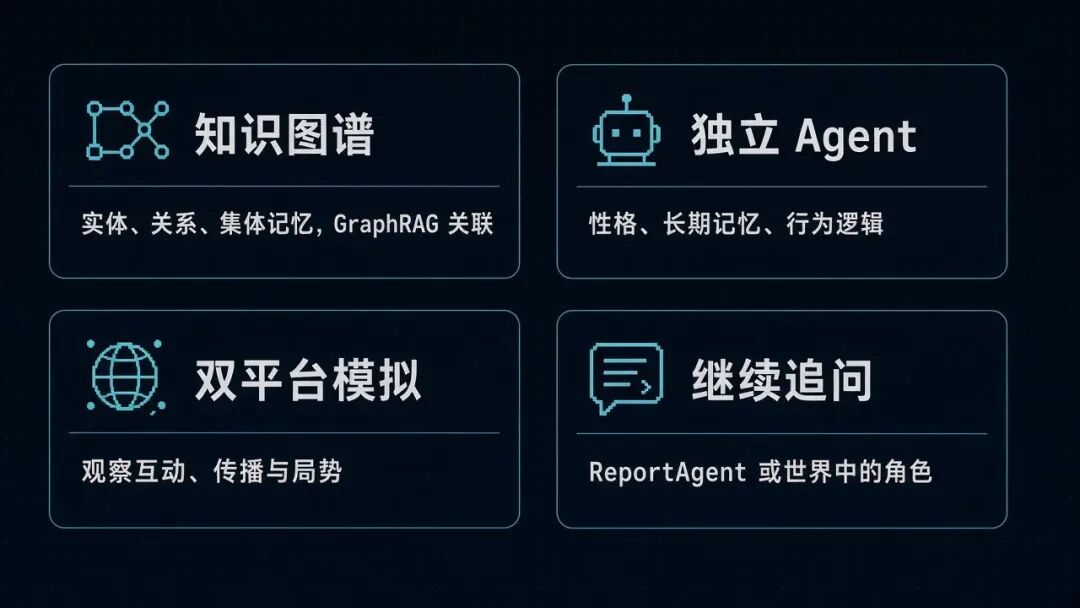
MiroFish会从用户上传的材料中提取相关信息,例如:实体、关系和集体记忆,然后用GraphRAG把这些信息进行关联。
这样一来,Agent获取的不仅仅时一段文本,它还附带人物关系、事件背景和前后文;当Agent进行模拟时更容易保持上下文。
自动生成不同的 Agent
每个 Agent 都有自己的性格、长期记忆和行为逻辑。
它们不会拿着同一套提示词行动。随着互动继续,记忆也会更新,最后呈现出的结果更接近一群人一起讨论时的状态。
在两个平台上同时模拟
项目支持在不同模拟环境中运行 Agent,观察角色之间如何互动、传播信息,以及让局势发生变化。
这对舆情分析、政策推演、市场假设和故事创作都比较有用。很多时候,群体怎么变化,比单独问模型一句话更值得看。
模拟结束后还能继续追问
报告生成后,你可以继续和 ReportAgent 对话,也可以直接询问模拟世界里的任意角色。
所以最后拿到的不只是一份 PDF,还能继续打开这个模拟环境,追问某个判断是怎么得出来的。
部署前先看看成本和环境
源码部署需要 Node.js 18 以上、Python 3.11 到 3.12,还要配置 LLM API 和 Zep Cloud。
仓库也提供了 Docker 部署方式。
官方提醒,模拟轮数越多,API 消耗越高。第一次体验时,可以先把轮数设少一些。
仓库地址:
1
https://github.com/666ghj/MiroFish
今天就分享到这,感谢阅读,希望对你有帮助。