综合 / 后端 · 2026-10-07 09:53 · 1 阅读 · 0 赞
6.4 万 Star 的开源爬虫 MediaCrawler:不逆向签名,一键采集小红书、抖音、B 站等 7 个平台公开数据
MediaCrawler 用 Playwright 浏览器自动化绕过签名加密,支持小红书、抖音、快手、B 站、微博、贴吧、知乎七个平台的内容、评论与创作者主页采集,本文介绍它的能力、原理与上手步骤。
写爬虫的都知道,现在写代码本身花不了多少时间,真正耗人的是签名。平台把接口参数加了密,想直接调接口,得先把它前端代码逆向一遍,搞清楚签名是怎么算出来的。平台隔三差五就改一次算法,脚本跟着就不能用了。2023 年小红书升级风控那阵子,满屏 461 状态码,死了一大批爬虫脚本,不少人就是那时候退坑的。
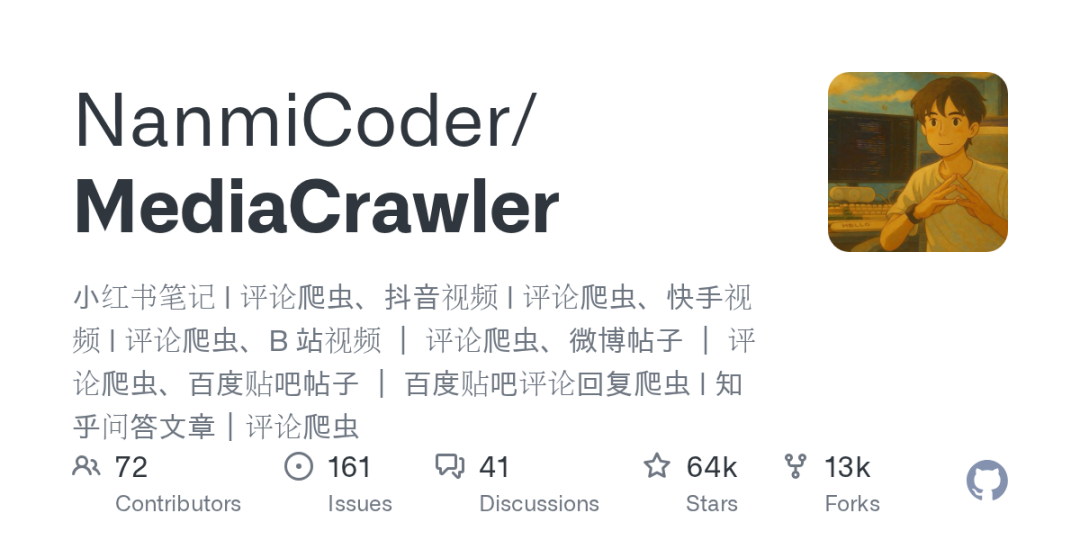
MediaCrawler 的思路不太一样,它不碰加密,用浏览器自动化拿数据,小红书、抖音、快手、B站、微博、贴吧、知乎,七个平台都在支持列表里,目前在 GitHub 上有 6.4 万 Star。作者是一名个人开发者,从 2023 年维护到现在,三年多了没断更。
这篇主要说两件事:它到底能干什么,还有怎么把它跑起来。
它能干什么
七个平台的功能基本一样,就不分开说了,按能力过一遍。
采内容有两种方式:
-
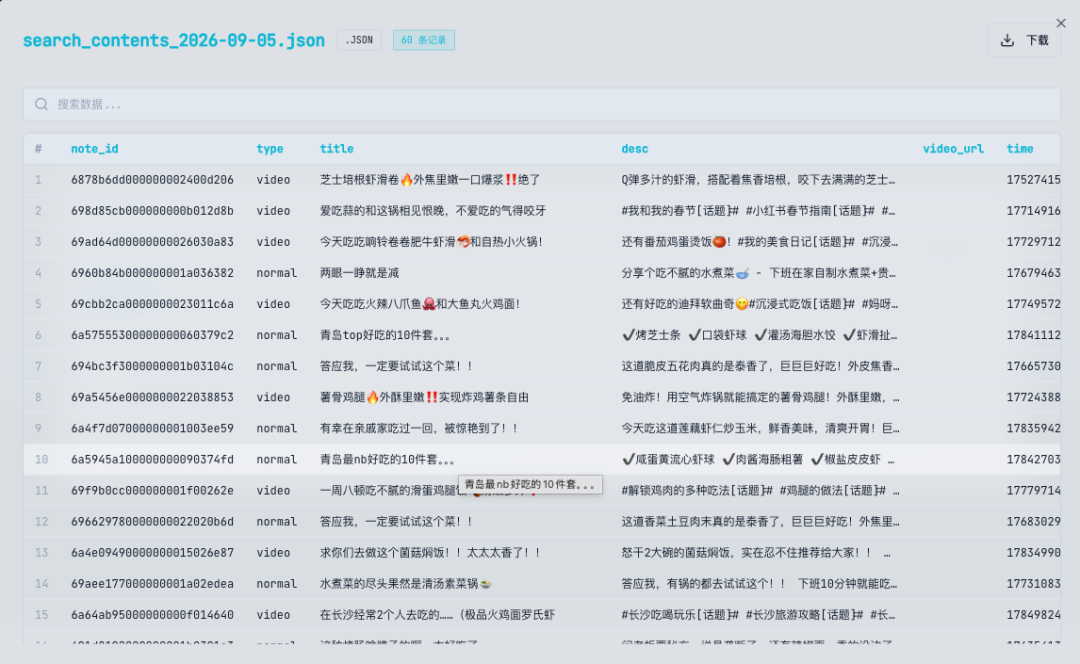
在配置里填关键词,它把搜索结果里的笔记和视频采下来,标题、正文、点赞数、收藏数、评论数都有。官方示例里填的是 deepseek、python 这种词,换成我们自己关心的话题就行。
-
如果手上已经有明确目标,把帖子或者视频的 ID 填进配置列表,它只采这几条,不用跑全量搜索。
评论这块做的很好。 一级评论全部拉下来,评论底下的回复,也就是大家说的楼中楼,也能一起采。我自己用下来,很多时候评论比正文还有用,做舆情分析或者找选题的时候尤其明显。采完的评论还能直接生成词云图,高频词扫一眼就知道大家在聊什么,不用一条条去翻。
输入美食,跑一圈:
除了单条内容,它也支持采创作者主页。 想盯某个作者,填他的主页,他发过的内容列表和对应数据都能拿到,这个能力七个平台都有。
登录方面,第一次用对应的 App 扫码登录,登录态会存在本地,之后再用就不用重复扫码了,失效了重新扫一次就行。它还支持挂 IP 代理池,代理资源要我们自己准备,采的量大的话建议配上。
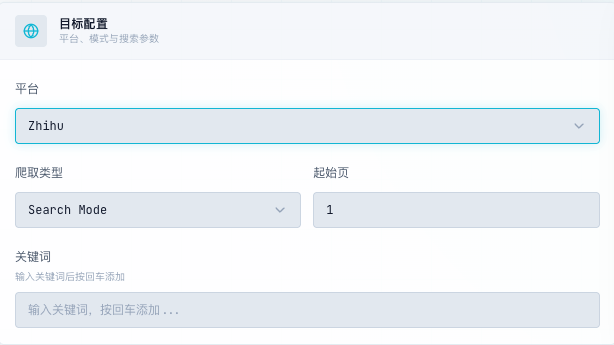
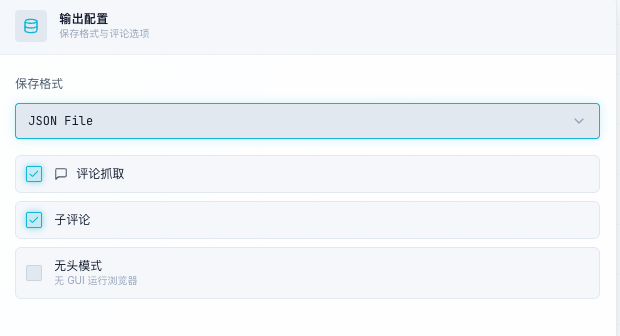
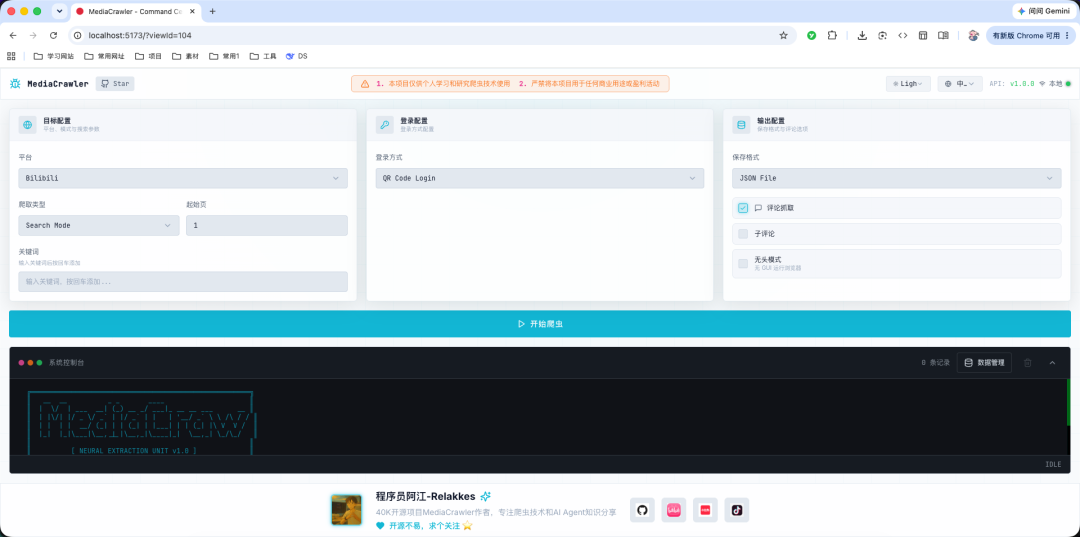
存数据这块给的选项挺多,CSV、JSON、JSONL、Excel 都行,也能直接写进 SQLite 和 MySQL,后面想接分析脚本很方便。不想碰命令行的话,它还有一个网页版的操作界面,选平台、填关键词、看日志、预览数据,都在浏览器里完成。
它是怎么做到的
前面说它不碰加密,这里展开说说。
它底层用的是 Playwright,一个浏览器自动化框架。我们扫码登录之后,登录态会被保存下来,之后需要签名的地方,让浏览器在登录状态里自己去算。平台改算法也没关系,反正签名是浏览器算的,跟代码没关系。这个思路不算它首创,不过真把它做到开箱即用、还覆盖七个平台的,我目前见到的就这一个。
它默认还会走 CDP 模式,连接的是我们自己电脑上天天在用的那个 Chrome,登录过的账号、Cookie 都能复用,平台那边看到的就是一个正常用户在刷网页。
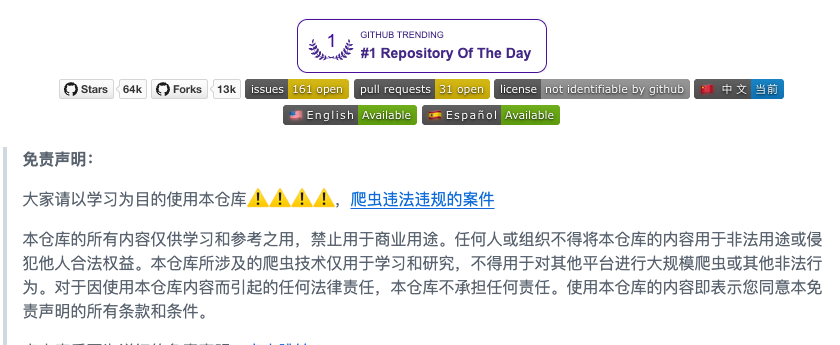
顺带说个事,这个项目火起来以后,作者一度把仓库删了,怕惹麻烦。后来代码被人拿去卖钱,他就补了一份免责声明重新开源,现在项目首页第一屏就是加粗的免责条款,合规这块作者挺上心的,后面我也会多说几句。
怎么把这个项目跑起来
clone 下来进目录,一句 uv sync 就把 Python 依赖装完了,README 推荐用 uv 管环境,确实省事。
另外要装个 Node.js,版本 16 以上就行,爬抖音和知乎的时候要用到。
浏览器这边,Chrome 要 144 以上的版本,然后开一个远程调试的开关,README 里写了步骤,照着点两下就好。
装完跑一句:
uv run main.py --platform xhs --lt qrcode --type search屏幕上会弹出二维码,拿手机 App 扫一下,登录态就缓存住了。想采什么关键词、采哪个平台、数据存成什么格式,都在 config/base_config.py 里改,配置项都带中文注释,看着改就行。
想用 WebUI 的话,启动也不麻烦,后端一条 uvicorn,前端一条 npm run dev,README 里都写了。
**如果还是觉得难,不想自己安装,可以打开Codex,说一下把NanmiCoder/MediaCrawler给我安装好,就OK了。
几个要注意的地方
有几个地方得讲清楚:
一是账号有风控风险。
毕竟是程序在操作,频率开太高,平台会盯上登录的那个号。我的做法是频率放低,只采公开数据,拿到自己要的东西就停,主力账号不建议拿来跑这个。
二是功能的边界。
开源版没有断点续爬,也不支持多账号,这些在作者的 Pro 版里,Pro 是付费订阅的。还有一点,它的开源协议是作者自定义的,跟 MIT 不一样,核心意思就一条,仅供学习研究,禁止商用。拿它接活挣钱、卖数据,那事情的性质就变了,爬虫惹上官司的案子,新闻里每年都有。
三是平台会一直升级。
今天能跑不代表三个月后还能跑,登录态失效、接口改版都是常态。好在项目从 2023 年 6 月开源到现在一直在更新,这在爬虫项目里算很难得的。
最后
对我来说这个项目的价值主要有两个,一个是省时间,想看看某个话题下大家在聊什么,不用再一条一条手动去抄。另一个是适合学东西,代码结构清楚,每个平台一个独立模块,想学浏览器自动化的,拿它当样本挺合适。
合规的事再多啰嗦一句,只采公开数据,频率放低,不碰个人隐私,不做商业用途。
开源地址:
**https://github.com/NanmiCoder/MediaCrawler
关注AI技术前哨,随时掌握最新的AI动态