综合 / 人工智能 · 2026-10-10 08:36 · 2 阅读 · 0 赞
AI开源项目日报2026.10.09:Agent与Skill生态爆发
本期AI开源日报聚焦Agent与Skill生态:Agent-Reach为Agent装上互联网感知能力,Anthropic开源11个职能插件库,openrig把终端会话组织成Agent团队,Qwen3.8-Flash-Next开放权重,决策型VLM JEV-27B-VL登榜。
一、今日速览
| # | 项目 | 平台 | 方向 | 核心指标 | 评分 |
|---|---|---|---|---|---|
| 01 | Panniantong/Agent-Reach | GitHub | Agent 基础设施 | 94,128★ | 周增 6,987★ | 97 |
| 02 | anthropics/knowledge-work-plugins | GitHub | AI Skill 官方库 | 27,526★ | 当日 +392★ | 93 |
| 03 | mvschwarz/openrig | GitHub | 多智能体编排 | 6,147★ | 周增 2,693★ | 90 |
| 04 | Qwen/Qwen3.8-Flash-Next | Hugging Face | LLM 权重 | 6,042 赞 | 164.1 万下载 | 92 |
| 05 | autotrust/JEV-27B-VL | Hugging Face | 决策型 VLM | 2,876 赞 | 153.3 万下载 | 88 |
一句话结论:今天的热度不在"更大的模型",而在"更强的连接层"——Agent 的感知能力(Agent-Reach)、能力的标准化分发(knowledge-work-plugins)、Agent 之间的组织方式(openrig),三条线同时升温。模型侧则出现一个值得单独看待的分支:决策模型(Decision Model)。
二、项目详情
01 | Agent-Reach —— 给 AI Agent 一键装上互联网能力
评分 97 / 100 | GitHub
项目简介
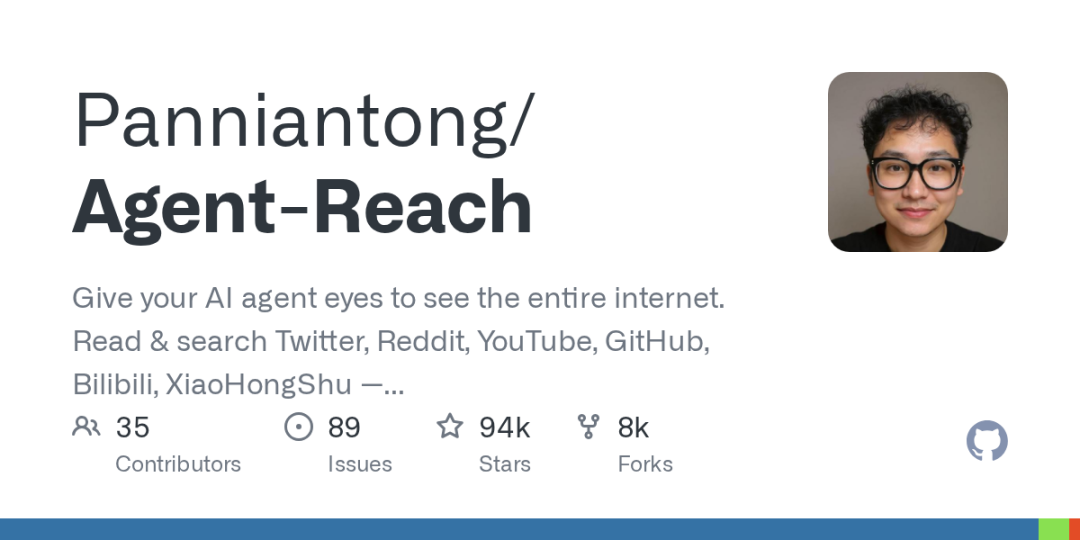
Agent-Reach 是一个面向 AI Agent 的互联网感知层 CLI。它把"让 Agent 能读推特、搜 Reddit、看 YouTube 字幕、刷小红书、读 B 站、抓任意网页、订阅 RSS"这类琐碎工程,收敛成一句安装指令。核心卖点是零 API 费用——所有工具开源、所有 API 免费,用户唯一的潜在成本是可选服务器代理(约 $1/月,本地电脑不需要)。
技术视角
- 多后端路由设计:每个平台采用"首选 + 备选"通道。某个接入方式失效时自动切换到下一个,用户无感。文档中给出真实案例——2026 年 6 月 yt-dlp 被 B 站风控封死,项目方直接切换到 bili-cli,用户零操作。
- 自诊断机制:
agent-reach doctor一条命令输出"哪个通、哪个不通、怎么修",把环境问题从"玄学调试"降级为"可观测状态"。 - 兼容性取向正确:不绑定单一 Agent 框架,Claude Code / OpenClaw / Cursor / Windsurf 等任何能执行命令行命令的 Agent 都可接入。
- 隐私边界清晰:Cookie 仅存本地,不上传。
数据支撑
| 指标 | 数值 |
|---|---|
| Stars | 94,128 |
| Forks | 8,232 |
| 周新增 Stars | 6,987 |
| 语言 / 许可 | Python / MIT |
| 创建 → 最后推送 | 2026-02-24 → 2026-10-08 |
理性分析
97 分的高分来自"痛点锋利 + 工程完成度高 + 许可宽松"三者叠加:Agent 落地过程中,"联网取数"几乎是所有团队都会撞上的同一堵墙,而 Agent-Reach 直接给出了可复用的答案。扣分项同样明确——它本质上在对抗第三方平台的反爬策略,长期维护成本必然随平台迭代而上升;同时数据抓取的合规边界需使用者自行承担。它的价值上限,取决于维护方能否长期跟上平台变化。
🔗 信息来源:https://github.com/Panniantong/Agent-Reach
02 | knowledge-work-plugins —— Anthropic 官方的 AI Skill 能力矩阵
评分 93 / 100 | GitHub
项目简介
Anthropic 官方开源的知识工作插件库,为 Claude Cowork 打造(同时兼容 Claude Code)。一次性放出 11 个按职能打包的插件——覆盖生产力、销售、客户支持、产品管理、市场营销、法务、财务等岗位,每个插件内含 skills、connectors、slash commands 与 sub-agents 四类资产。官方定位很清楚:先给你一个"该岗位的强力起点",真正的价值发生在企业按自身工具、术语、流程做定制之后。
技术视角
- 从"提示词"到"可安装能力包":这是本项目的真正信号价值。过去企业交付 AI 能力靠文档 + 提示词,如今收敛为带连接器、斜杠命令、子代理的结构化安装单元,可版本化、可分发、可审计。
- 连接器即护城河:每个插件预设了目标职能的 SaaS 连接器组合(如 sales 对接 HubSpot / Close / ZoomInfo,marketing 对接 Canva / Figma / Ahrefs / Klaviyo),把"模型能力"翻译成"岗位工作流"。
- 双端兼容:以 Cowork 为主设计,同时兼容 Claude Code,覆盖面被显著放大。
数据支撑
| 指标 | 数值 |
|---|---|
| Stars | 27,526 |
| Forks | 3,197 |
| 当日新增 Stars | 392 |
| 语言 / 许可 | Python / Apache-2.0 |
| 插件数量 | 11 个职能插件 |
理性分析
93 分中,官方背书与 Apache-2.0 商用友好贡献了大部分权重。需要保持清醒的是:这套插件深度绑定 Anthropic 自家生态,对其他模型的迁移成本较高;同时"插件市场"这一形态仍处于早期,真正的分水岭不在插件数量,而在于企业二次定制后的实际采纳率。把它当作 Skill 工程化标准的参考实现来读,价值高于直接拿来即用。
🔗 信息来源:https://github.com/anthropics/knowledge-work-plugins
03 | openrig —— 把零散终端会话变成一支有编制的 Agent 团队
评分 90 / 100 | GitHub
项目简介
openrig 的定位一句话说透:"A harness wraps a model. A rig wraps your harnesses."(harness 包裹模型,rig 包裹你的 harnesses)。你用 YAML 定义一支 Agent 团队,一条命令拉起;Claude Code 与 Codex 可以存在于同一个 rig 内,被当作一个系统统一管理。目标是终结"一堆散落的终端窗口",把 AI 编码助手升级为持久化的、有角色分工、共享上下文的团队。
技术视角
- 组织抽象层:与主流"单 Agent 工具"路线不同,openrig 抽象的是团队拓扑——角色、层级、共享上下文、工作归属。用户对 lead agent 描述目标,由它在团队间协调专家并回收结果与待决策项。
- 多厂商并存:同一 rig 内混合 Claude Code 与 Codex,避免了被单一模型供应商锁死,这在企业环境里是一个务实选择。
- 环境约束需注意:依赖 Node.js 22/24 + tmux,支持 macOS / Linux,Windows 需走 WSL2(原生不支持,且自动化测试在 WSL2 上尚未跑通);启动 rig 会写入 provider hooks 与 workspace trust 配置,官方明确提示需先备份相关文件。
- 项目方自述这是其"AI civilization 实验"背后的开源系统,属于长期在跑的真实工程而非演示项目。
数据支撑
| 指标 | 数值 |
|---|---|
| Stars | 6,147 |
| Forks | 449 |
| 周新增 Stars | 2,693 |
| Star/Fork 比 | ≈ 13.7(同量级项目中偏高) |
| 语言 / 许可 | TypeScript / Apache-2.0 |
理性分析
90 分。Star/Fork 比约 13.7,说明"收藏围观"的人远多于"动手改造"的人——这通常意味着概念吸引力强,但上手门槛被环境依赖(tmux、WSL2、hook 注入)显著抬高了。这类"Agent 组织层"产品的真实考验不在功能表,而在于协调开销是否真的低于人工切换。当前阶段它更像一个高质量的方法论样本,适合有闲置工程能力、愿意折腾的团队试跑。
🔗 信息来源:https://github.com/mvschwarz/openrig
04 | Qwen3.8-Flash-Next —— Qwen4 架构的开放权重先手
评分 92 / 100 | Hugging Face
项目简介
这不是一次普通的权重发布,而是支撑 Qwen4 的架构的实验预览,也是该架构下的首个开放权重版本。Qwen 官方给出的问题意识很直接:当基础模型同时朝"更大参数"和"更长上下文"两个方向推进时,真正的瓶颈已不是"能扩多大",而是"能扩得多高效"。
技术视角
- Hybrid Attention with QSA:把此前的 Gated DeltaNet + Gated Attention 组合,重构为 Gated DeltaNet + Qwen Sparse Attention。关键差异在于 QSA 以 micro-block(微块)为粒度做选择,而非逐 token 选择——官方称这显著降低长上下文的延迟,而"Agentic 工作负载正在主导真实使用场景"正是这项优化的动因。
- Gated Residual:通过逐元素的、数据依赖的读门控,对加宽后的残差流做信息调制,用于支撑更深层的稳定训练。
- 工程配套完整:权重为 Transformers 格式,兼容 vLLM / SGLang / TokenSpeed 等主流推理栈;官方另有托管版 Qwen3.8-Flash(默认 1M 上下文 + 内置工具)。
数据支撑
| 指标 | 数值 |
|---|---|
| Likes | 6,042 |
| Downloads | 1,640,938 |
| 任务类型 | image-text-to-text |
| 最后更新 | 2026-08-27 |
| 许可 | Qwen Community 1.0 |
理性分析
92 分。164 万次下载量是它进入榜单最硬的依据——这说明它已被大量实际管线采用,而非停留在"点赞收藏"。需要标注的风险点也很清楚:这是实验性预览,官方措辞明确指向"Qwen4 架构的先行验证",意味着 API 与行为可能随正式版演进;许可是 Qwen Community 1.0(非标准 OSI 许可),商业使用方应逐条核对条款。对做 Agent 与长上下文应用的团队来说,它值得尽早进入测试矩阵。
🔗 信息来源:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
05 | JEV-27B-VL —— 决策模型(Decision Model)这条分支浮出水面
评分 88 / 100 | Hugging Face
项目简介
JEV-27B-VL 是一个决策型视觉语言模型:输入一个状态 + 一组带类型的问题(schema),输出每个问题的每个候选项的概率,一次前向完成。它不做自由文本生成,因此也不需要输出解析。当前它在社区独立评测 Jev Decision Index 0.3 — Vision 榜上排名第 1 / 20。
技术视角
- System 1 适配器 + 决策头:视觉编码器保持 Qwen3.8-27B 原样不动(未针对图像训练),仅用纯文本数据训练 System 1 适配器与决策头,因此图像侧是零样本迁移。
- 带校准的概率输出:其 calibration error(ECE)为 0.019,在榜单中处于低位——这意味着输出的概率值本身可信,可直接参与阈值决策,而不只是做排序。
- 架构对照组值得注意:同期的 Cloudflare/clef 走的是另一条路线(基于 Qwen3.8-27B 后训练 + 联合 schema head,输出每个候选项一个 logit 再 softmax)。两个模型同一基座、同一目标、两条不同实现路径,且 clef 明确声明 API 与 Jev / SystemOne 兼容——一个围绕"决策"的互操作接口层正在自发形成。
数据支撑(Decision Index Vision 榜)
| 排名 | 模型 | Full score | 公开基准 | 私有测试 | ECE |
|---|---|---|---|---|---|
| 1 | JEV-27B-VL | 69.82 | 72.78 | 66.86 | 0.019 |
| 2 | Solomon v1.1 (27B) | 67.66 | 69.80 | 65.52 | 0.076 |
| 3 | Xor 1.2 (35B-A3B) | 64.30 | 70.32 | 58.27 | 0.008 |
| 参考 | Qwen3.5-397B-A17B(原版 VLM) | 63.44 | 68.52 | 58.37 | — |
平台指标
| 数值 |
|---|
| Likes 2,876 |
| Downloads 1,533,034 |
| 基座 / 方式 Qwen3.8-27B / LoRA adapter |
| 许可 Apache-2.0 |
| 最后更新 2026-10-08 |
理性分析
88 分。最亮的一条数据是:+6.4 Full-score 领先原版 Qwen3.5-397B-A17B 参考,同时总参数约为其 1/15,且私有测试集(用未公开的新图片构建)同样第一——这排除了"过拟合公开榜"这一最常见的质疑。扣分主要来自三条:其一,评测来自社区榜单而非同行评审;其二,榜单当前仅 20 个模型,竞争密度有限;其三,autotrust 属于治理信息相对不透明的发布方。结论应表述为"在特定决策评测口径下表现领先",而不是"整体超越大模型"——这两者差距很大。
🔗 信息来源:https://huggingface.co/autotrust/JEV-27B-VL
🔗 榜单来源:https://huggingface.co/spaces/multimodalart/jev-decision-index
三、技术观察:今天真正的三条暗线
暗线一:Agent 的竞争重心,从"模型能力"转向"连接能力"。
Agent-Reach(94,128★)与 openrig(6,147★ 但周增 2,693★)同一天在榜,指向同一件事——模型能力正在被快速拉平,而 Agent 能触达多少外部世界、能以什么结构组织自己,正在成为新的差异点。Agent-Reach 解决"看得见",openrig 解决"排得开"。
暗线二:Skill / Plugin 正在标准化为分发单元。
Anthropic 官方一次性放出 11 个职能插件,把 skills + connectors + slash commands + sub-agents 打包成可安装资产。这意味着 AI 能力的交付形态,正从"写提示词"演进为"发插件包"——版本化、可分发、可审计。对企业和开发者而言,这比任何一个具体插件的功能都更值得关注。
暗线三:模型侧出现"决策模型"这一独立分支。
JEV-27B-VL 与 Cloudflare/clef 同基座(Qwen3.8-27B)、同目标(输出校准概率而非文本)、双路线实现,并且已在接口层互相兼容。这是 LLM 从"生成"走向"判断"的一个明确信号:当应用场景从聊天转向自动化决策,输出形态会从自由文本切换为结构化概率。这条线的下一步,值得单独跟踪。