综合 / 后端 · 2026-10-13 08:13 · 3 阅读 · 0 赞
80.6k Star 的 Netdata:装完不用配的 AI 全栈监控
Netdata 是一个开源实时性能监控平台,装完自动发现机器上的服务并生成仪表盘,秒级采集数据,内置无监督机器学习异常检测,支持多种导出与告警,适合个人 VPS 与小团队快速搭建监控。
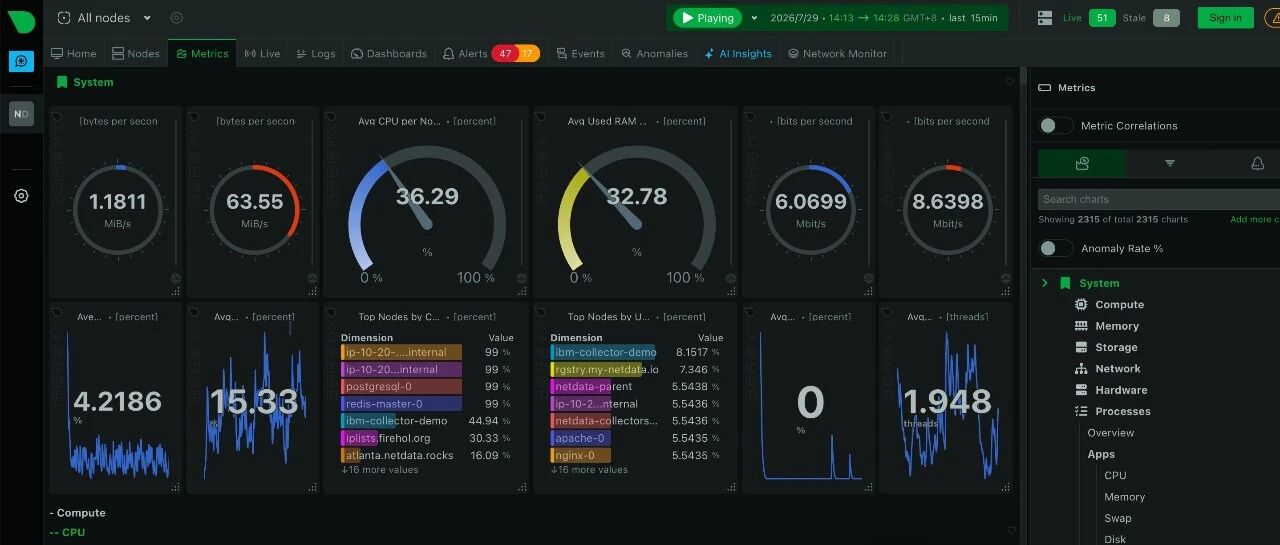
把服务器监控做成装完就能看的仪表盘,Netdata 值得拆开看。
做后端这些年,监控工具我前后用过不少。Zabbix 的配置量是真的大,新人上手很容易被劝退。Prometheus 加 Grafana 算是现在的标准答案,可每加一台机器就得改一次配置,PromQL 写多了也挺烦。
前两天翻到 Netdata 这个项目,号称装完什么都不用配,我就把它的 README 和官方文档翻了一遍,想看看它到底能省多少事。目前八万多 Star。
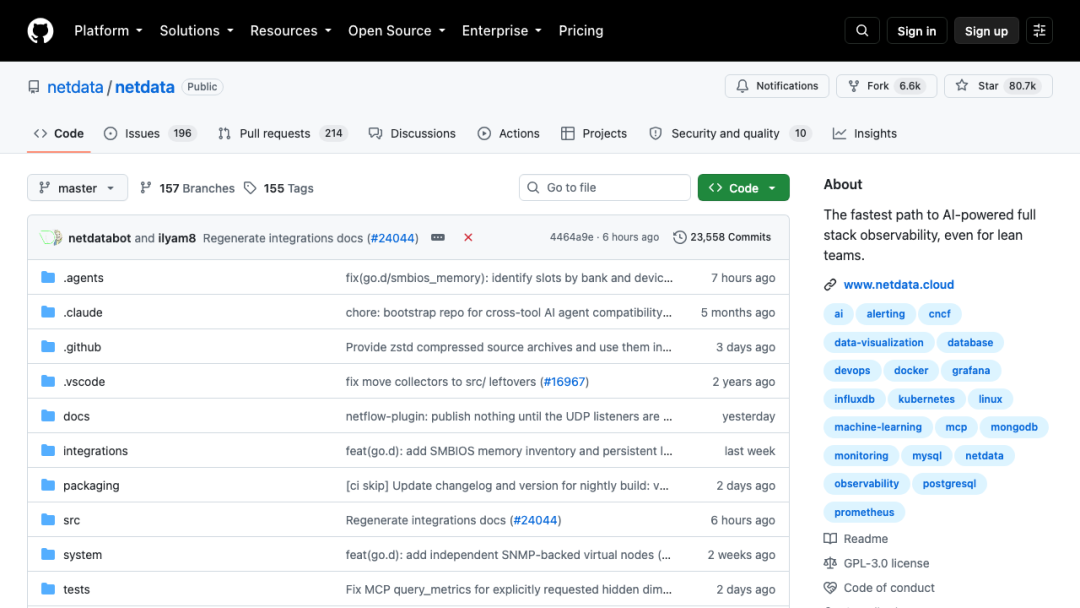
— netdata/netdata 仓库首页,Star 80.7k
先看它是什么
Netdata 是一个开源的实时性能监控平台。用法很简单,在服务器上装一个它的 agent,打开浏览器,整台机器的运行状态就全部摆在眼前了。CPU、内存、磁盘、网络、进程这些系统指标都有,MySQL、Redis 这类应用指标也在里面。
官方现在给它的定位是 AI 加持的全栈可观测平台。翻译成大白话就是,它不光把数据摆出来给你看,还会自己判断哪些指标不太对劲,排查问题的时候把最可疑的排到前面来。
它的架构分三层。Agent 是核心引擎,负责采集、本地存储、模型推理、告警评估和数据导出,跑在你自己的机房;Cloud 提供多节点的统一视图和集中告警配置,但不存放原始指标;UI 就是那套仪表盘,通过 CDN 分发。
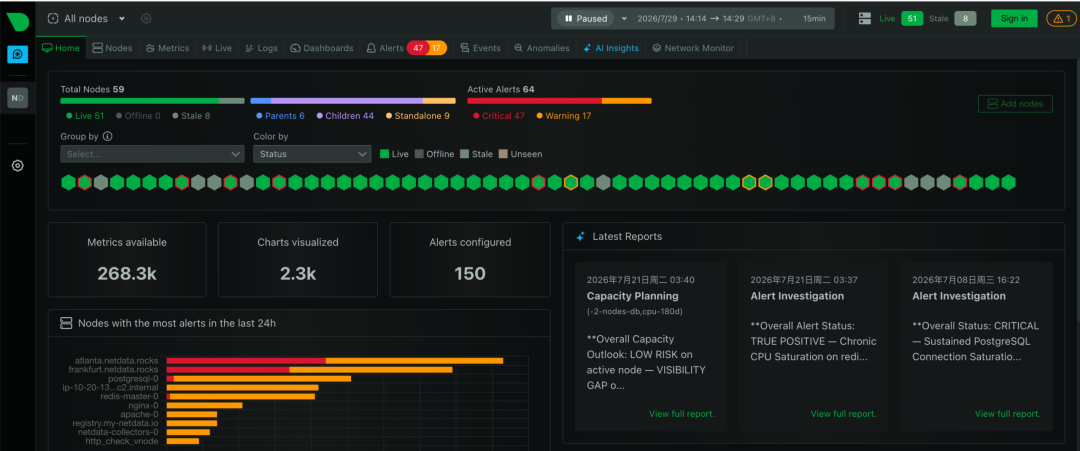
— Netdata Cloud 的节点与告警总览
装完它自己就知道机器上有什么
它现在支持八百多个集成,操作系统的指标、容器、虚拟机、硬件传感器、数据库、Web 服务这些都有,基本上服务器上跑什么它就能认什么,MySQL、PostgreSQL、MongoDB、Nginx、Docker 全在名单里。
比较关键的一点是,你不用告诉它机器上装了什么东西。装完之后它自己把机器扫一遍,发现有什么就监控什么,连仪表盘都是自动生成的。
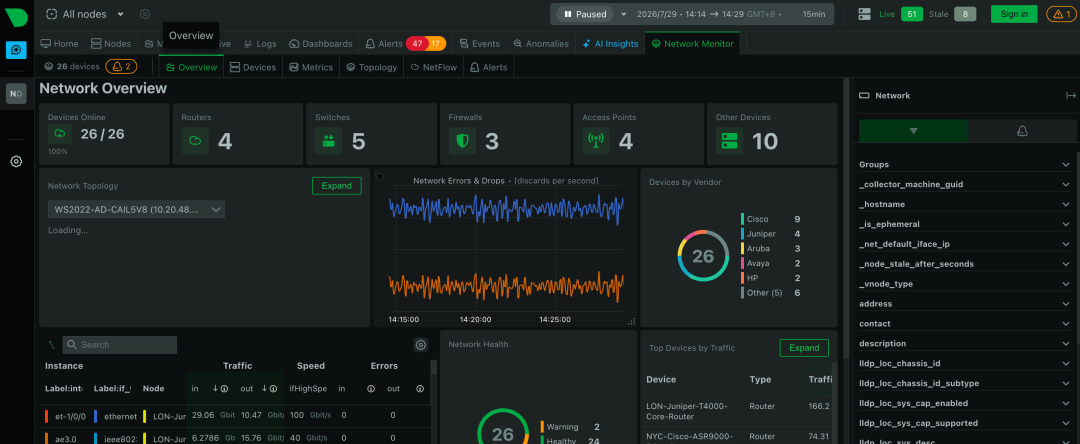
— Network Overview 里自动发现出的网络设备
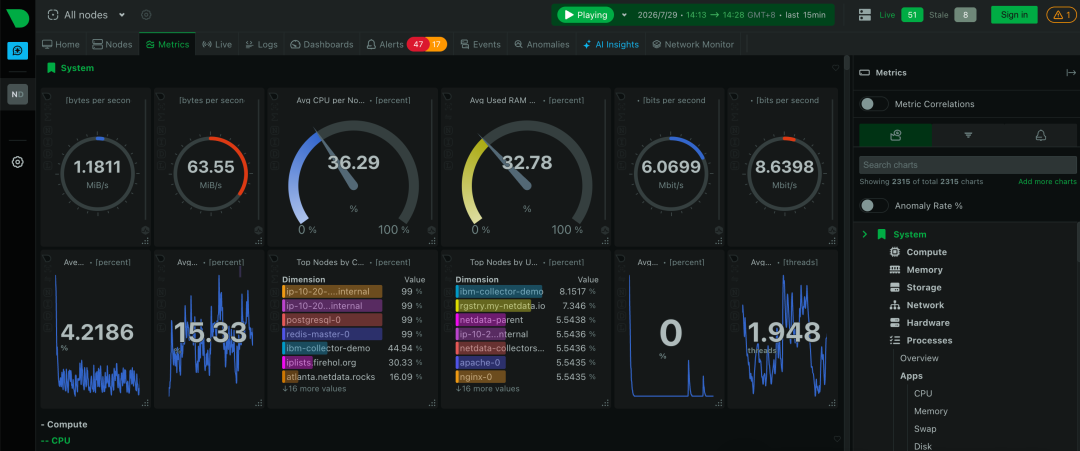
— Metrics 分区的 System 概览与 Top Nodes
用 Prometheus 的话,加一台机器就得配一次 exporter,每个服务都要单独接一遍。Netdata 把这一步整个省掉了。
顺带说清楚一件事,自动发现不等于不能手动配。它默认把能认的都认了,你想自己加一个收集器或者调整采集项一样可以,只是绝大多数时候用不上。它也能吃 OpenMetrics 和 StatsD 这两种通用格式,应用自己吐的指标接得进来。
数据是一秒一条,抖动藏不住
它的数据是每秒采集一次的,采完之后马上就更新到图表上,延迟大概也就一秒。
这个听着好像没什么,实际用起来差距挺明显的。很多监控工具是 30 秒甚至一分钟才采一轮,那种只持续几秒钟的 CPU 飙高、网络抖动,在图上直接就被平均掉了,事后想查都查不到。线上有种故障很头疼,出了问题又自己恢复,想复现都复现不了,一秒级的数据就是为了抓这种。
点鼠标就行,不用学查询语言
用过 Prometheus 的都知道,想看点稍微复杂的数据就得学 PromQL。Netdata 不走这条路,在图表上用鼠标直接点就行。按机器分组、按网卡分组、按指标维度筛选,都是点几下就能完成的事。
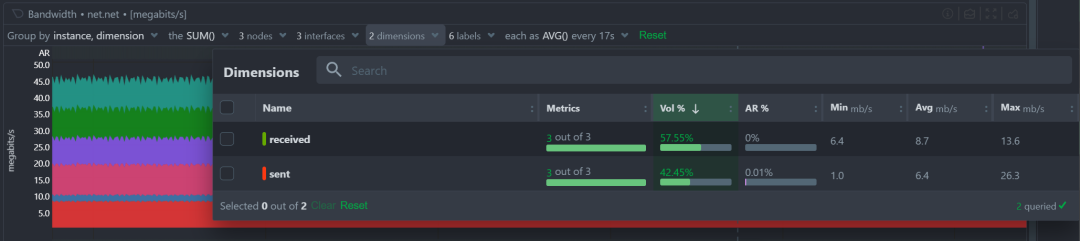
— 在图表上展开维度面板做筛选
十八个模型投票,才判一次异常
它的异常检测用的是无监督机器学习。每个指标都会训练 18 个模型,每个模型看不同时间窗口的历史数据,学这个指标平时正常的时候长什么样。判断异常的时候是 18 个模型一起投票,要全部都认为异常才算数,这样误报就压下来了。
训练是在你自己的机器上跑的,数据不用发出去。装完大概 15 分钟就能出第一批结果,跑上两天模型就全部训练完了,中间你什么都不用管。
出问题的时候它还有一个 Anomaly Advisor,会把当前最可疑的指标按顺序排出来。以前排查问题是自己对着几十张图一张张猜,现在可以先看它给的排名。
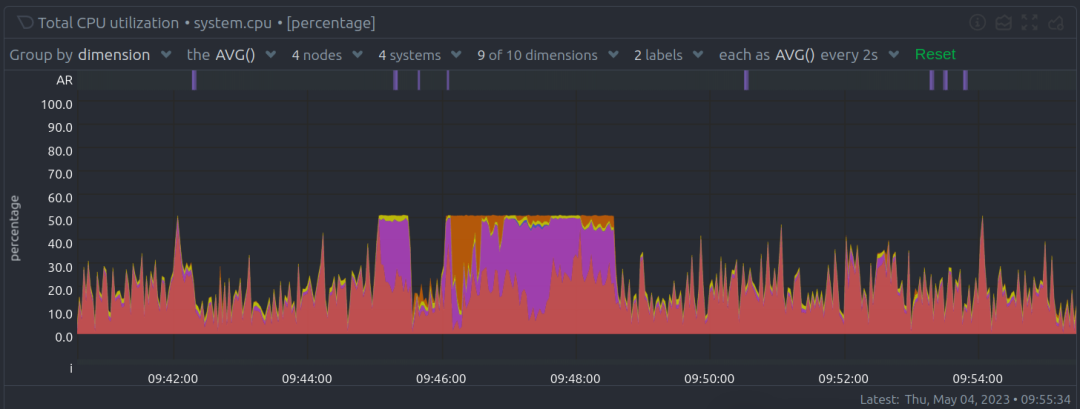
— CPU 图表顶部的异常标记与筛选条
告警开箱就有,Claude Code 也能直接读
它自带了几百条预置告警规则,磁盘快满了、内存有泄漏的迹象、网络错误率上升这些常见问题都覆盖到了。通知方式支持邮件、Slack、PagerDuty、Webhook,用 Webhook 转一手的话,企业微信和钉钉也能接上。邮件这条只要有 MTA 就默认可用。
如果团队本来就在用 Claude Code、Codex 这类 AI 编程工具,还能把它们接到自己的监控数据上,然后用大白话问问题,比如昨天下午那台机器的 CPU 为什么突然爆了,它会自己去查数据然后给出分析。
自己占得少,数据也不出机器
监控工具最怕的就是自己变成负担。官方给的数据是,单机每秒收 5000 个指标的情况下,大概占单核 CPU 的 5%、200MB 内存。阿姆斯特丹大学 2023 年做过一个研究,对比了一圈监控工具之后认为它在 CPU、内存和执行时间上都更优。
采集到的数据也存在你自己的机器上,每个采样点压缩之后大约只占 0.5 字节,磁盘够大的话能存好几年。想把数据接到已有的监控体系里也行,它除了导出到 Prometheus,还支持 InfluxDB、Graphite、OpenTSDB,Grafana 也有现成的数据源插件。
它还能直接读 systemd-journald 和 Windows 事件日志,日志在本地处理完再可视化,不用单独搭一套日志系统。另外它有一个打分引擎,会跨指标找关联,比如某台机器的 CPU 飙高是不是因为隔壁那台挂了,这一点上面提到的 Anomaly Advisor 是同一条思路。
装起来也是它最省事的地方
安装这件事它做得比同类都简单。单机、容器、多机三种情况各有一条路,装完统一访问 19999 端口,仪表盘已经在那儿了。
一条命令装完
Linux 机器上执行这一条就行。
wget -O /tmp/netdata-kickstart.sh https://get.netdata.cloud/kickstart.sh && sh /tmp/netdata-kickstart.sh
脚本会先落到 /tmp 再执行,装完打开浏览器访问 http://服务器IP:19999,仪表盘直接就有了,中间不需要做任何配置。macOS、FreeBSD、Windows 也都能装,K8s 环境有专门的部署方式,这些在官方文档里都写得很清楚。
Docker 里跑一个容器
不想在宿主机上装东西,就用容器跑。
docker run -d --name=netdata -p 19999:19999 --cap-add SYS_PTRACE -v /:/host/root:ro,rslave netdata/netdata
-p 把 19999 端口映射出来,--cap-add SYS_PTRACE 是让容器能看清宿主机上的进程,-v 那一段把宿主机根目录以只读方式挂进去,这样它才能看到宿主机的磁盘和网络。跑起来同样是访问 19999 端口。完整挂载参数其实更多,建议照着官方文档抄,上面这条是最精简能跑起来的版本,日常够用。
多了几台机器怎么办
每台机器各装一个 agent 就可以了。想要一个统一入口的话有两个办法,一个是注册 Netdata Cloud,把几台机器关联到一起,免费额度个人用是够的;另一个是不想碰云的话,可以自己搭一个 parent 节点,让其他 agent 把数据汇总过来。
什么人最适合装它
手里有几台云服务器或者个人 VPS,想随时看看实时状态的,这是最基础的用法,装完就能用。
线上问题排查,一秒级的数据在抓瞬时抖动这件事上比粗粒度监控强很多,特别适合那种出了问题又自己恢复、想复现都复现不了的故障。
跑 AI 训练或者推理任务的机器,GPU 的功耗、温度、显存占用都可以实时盯着,任务跑飞了能第一时间看到。
小团队不想维护 Prometheus 加 Grafana 那一整套的,也可以考虑它,一个工具能顶好几个用。
两个不足,以及我的建议
不足的地方也得说一下。官方心思明显放在 Netdata Cloud 上,一部分 AI 排障能力也留在云端。纯自托管的话,核心监控和异常检测都能用,但体验不是满血。另外它的强项是基础设施这一层,如果要的是完整的应用性能追踪,还得再配别的工具。
建议是,手里有服务器就装一个试试,反正一行命令,数据也不出自己机器,就算最后只看看实时曲线也不亏。小团队从零开始搭监控,可以先拿它顶着用。