综合 / 代码人生 · 2026-10-29 15:42 · 1 阅读 · 0 赞
八天烧了25亿token,12G显存跑AI短剧的残酷真相
作者用4070 Ti本地生成AI短剧,八天消耗25亿token,换来3分01秒成片。文章剖析了12G显存下时间与像素的双重瓶颈,并分享试错经验与本地/云端策略。
八天成片 · 全部本地生成 · 一张 4070 Ti
我用我这台 4070 Ti 跑了八天,成片 1536×832,配音字幕后期配齐。拍的是《我为万界当狱卒》的第一章,这本书是我正在存稿的小说。八天,一共就这 3 分 01 秒。
12G 显存部署 H3,跑一段 5.17 秒的成品大概要 6 分钟。3 分 01 秒满打满算也就 35 段,三个多小时的事,为什么要八天呢?
每天晚上挂好 agent 任务,跑一整夜,第二天起来看片段,有两三天片段被我全部作废,一个用不了。
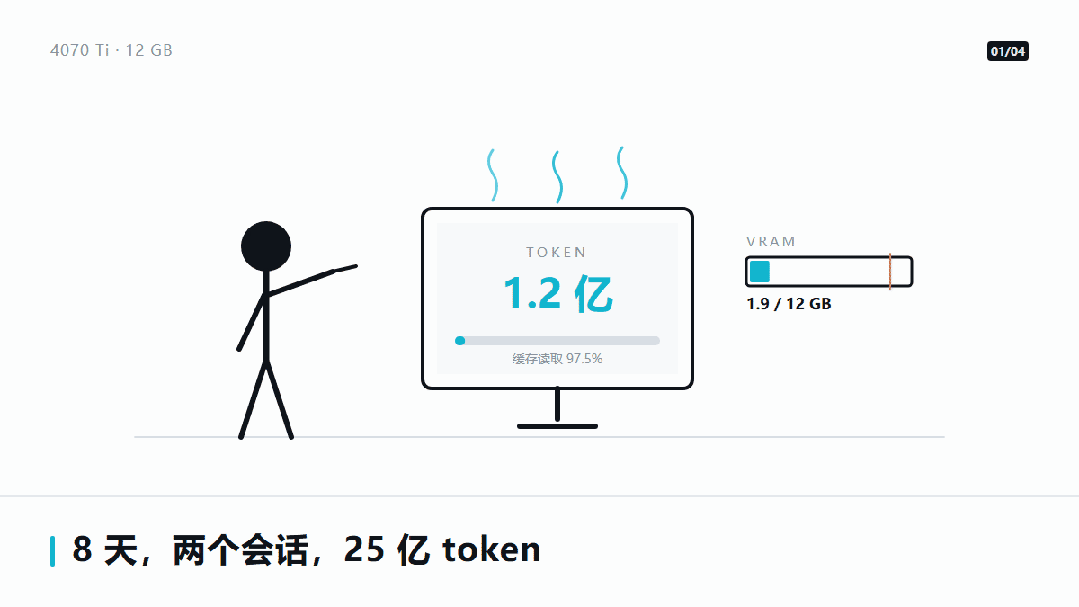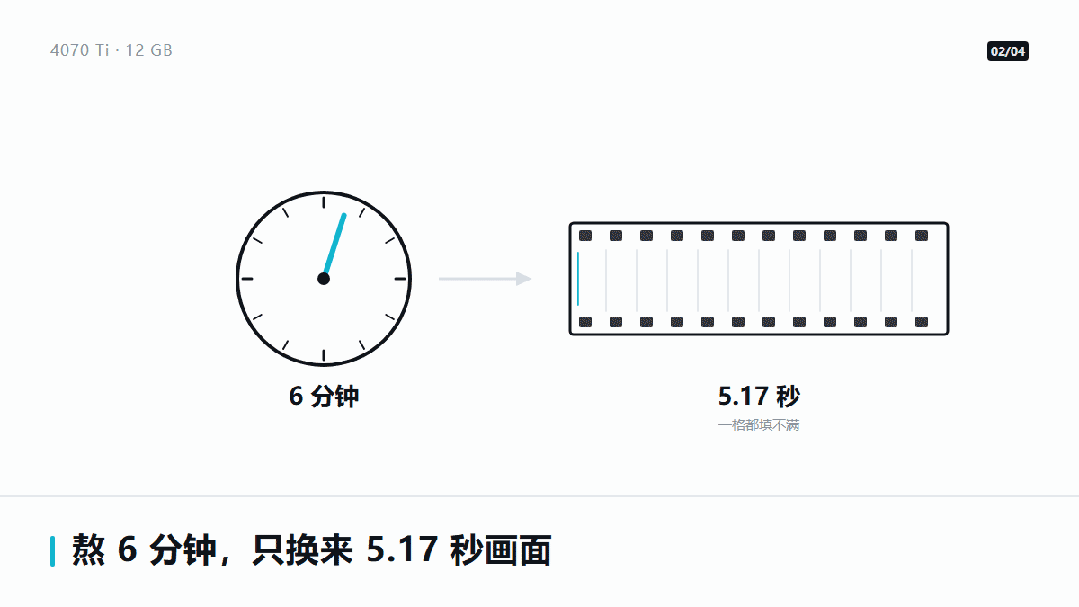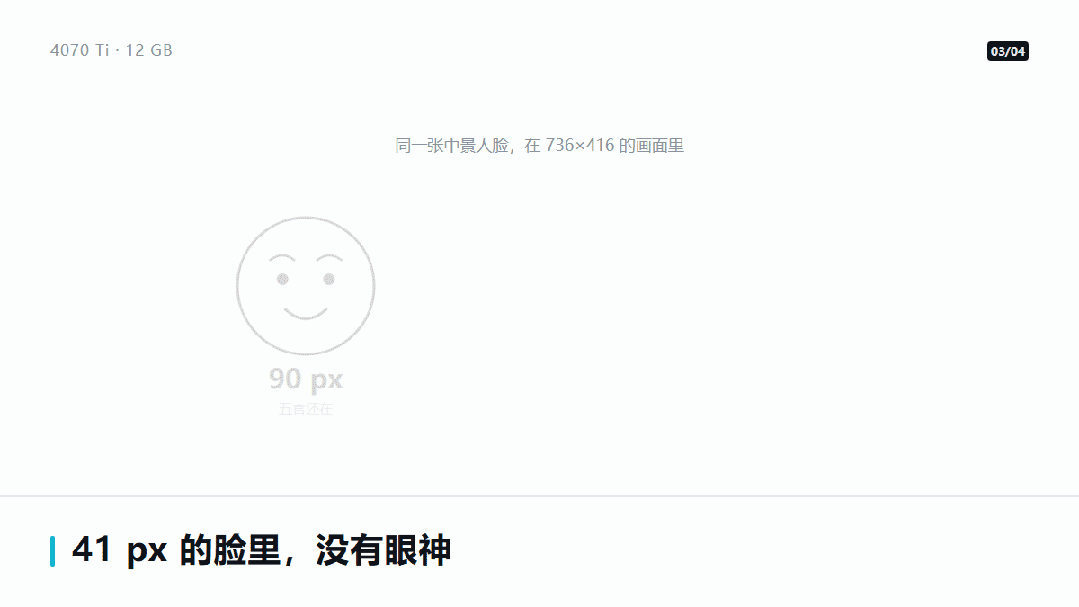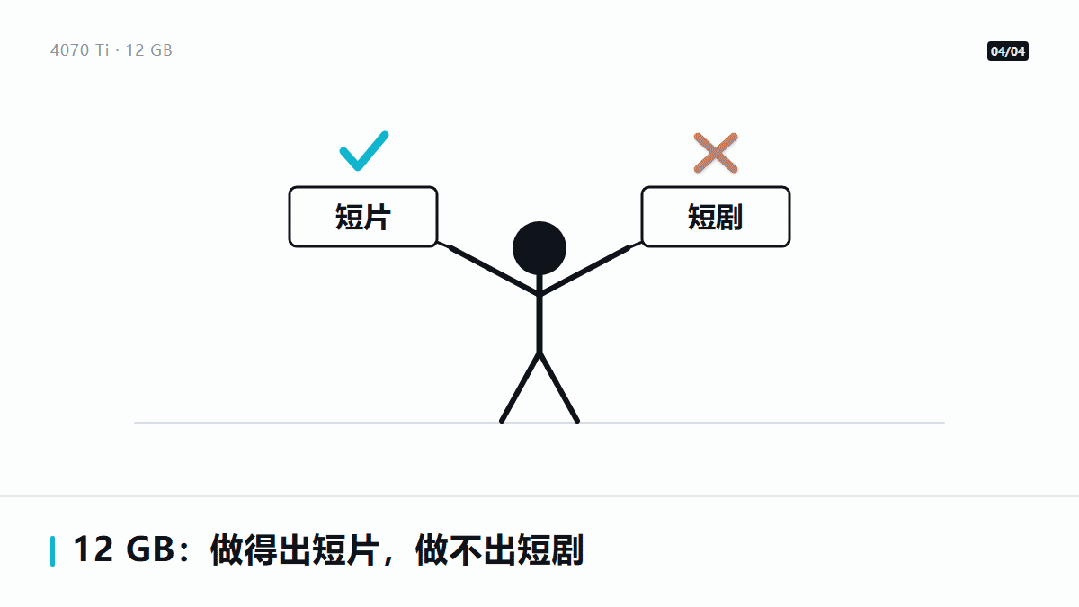
8 天,两个 Claude 会话,25 亿 token,换回来 3 分 01 秒。折下来,1 秒钟的画面要烧掉 1386 万 token。
25 亿
八天烧掉的 token 总吞吐
3 分 01 秒
换回来的全部成片
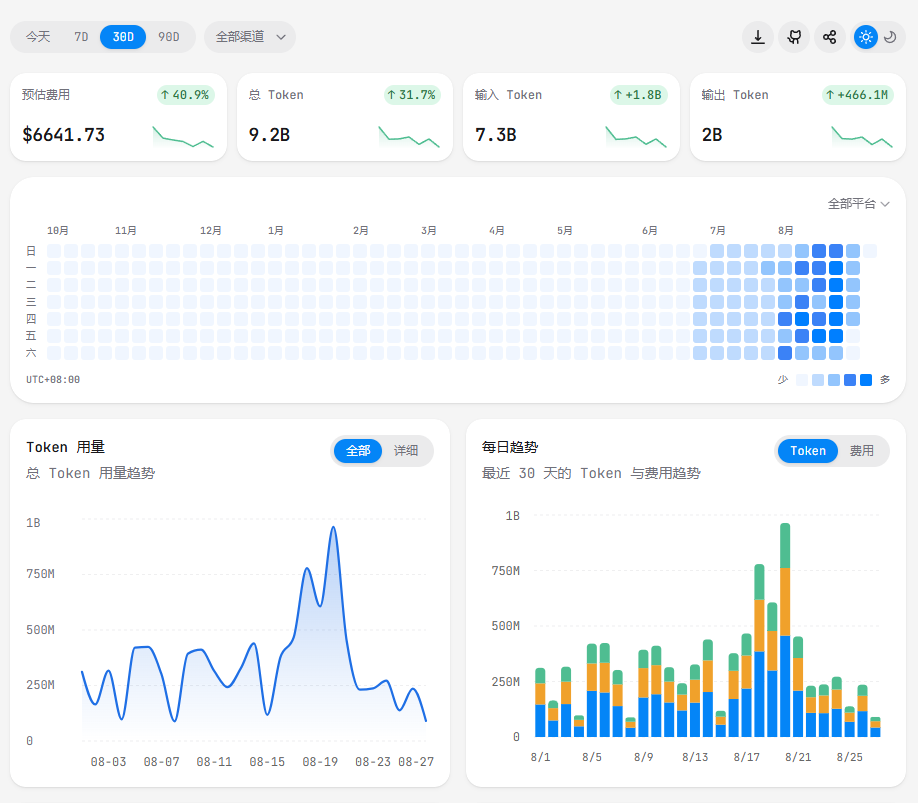
—掘金的 token 统计,30日总消耗92亿token
我想告诉大家的是,12G 显存暂时出不了短剧,可以先往氛围感短片、电影预告片这些方向考虑。
当然 25 亿这个数是账面吞吐:
项
数量
缓存读取
24.5 亿
缓存写入
5504 万
真·新读入
11500
真·新生成
694 万
九成七半都是缓存读取。跟 AI 每聊一轮,模型都得把前面几十万字的上下文重看一遍。真正产生的只有 694 万 token,五百万字上下,差不多一本完本网文。
烧完这些,我拿到的结论是:12 GB 这张卡做得出 AI 短片,做不出 AI 短剧。就差一个字,但卡住的地方有两处,一处是时间,一处是像素。
本文看点
01
6 分钟只换 5.17 秒
02
中景脸只有 41 像素
03
25 亿全烧在试错上
01 DEFINITION
短片和短剧,不是一回事
短片是几十秒到几分钟的一锤子买卖,观众看的就是个气氛,画面过得去就行,人脸糊一点,大家自己会脑补过去。短剧没这待遇。一集 2 分钟,动辄八九十上百集,观众得在第 7 集认出第 1 集那张脸,大量姿势、动作、场景、角色都需要一致性。高深一些的分镜、硬切、导演思维等等就更不必说。
短片
看气氛
脸糊一点,观众自己脑补
短剧
看人
一百集里得是同一张脸
如果按短片的标准,我这两集勉强算过了,但是按短剧的标准还差挺远。
02 THROUGHPUT
第一处:6 分钟,换 5.17 秒
机器是这么个配置,参数也是折腾到最后才跑通的:
项
值
卡
RTX 4070 Ti,12 GB
内存
32 GB
模型
MiniMax H3 官方 DiT(20 GB safetensors)+ GGUF 文本编码器
显存峰值
11.5 / 12
内存峰值
31.2 / 32
生成分辨率
736×416 = 0.31 MP
单段耗时
5.17 秒的画面 ≈ 6 分钟
运行过程中,显存和内存两头都只剩不到 1 GB。跑批的时候不能开 ComfyUI 的网页,前端一刷新就 OOM;每段跑完还得把 ComfyUI 重启一次。所以夜跑脚本只能写成彻底无人值守的,我睡我的,它自己起自己停。
重点
显存 11.5 / 12,内存 31.2 / 32。两头同时贴着天花板跑,中间任何一个环节多占几百 MB,整夜的活就白干。
有人可能要问,主体为什么不一起换成 GGUF,那不是更省显存?
safetensors 走 mmap,内存吃紧的时候系统还能把它换出去,GGUF 是实打实赖在内存里的。
我内存那头已经 31.2/32 了,真换过去,先撑爆的是内存。最后就凑出来主体 safetensors、文本编码器降 GGUF 这么个别扭组合。
分辨率只有 0.31 MP。社区教程写的 1344×768,但是 12G 这张卡上根本起不来。
帧数也不能随便填,得落在 17k+5 这个网格上:124 帧是 5.17 秒,训练下限;362 帧 15.08 秒,上限。这是 H3 的时序压缩结构定死的。填个 130 帧它也不报错,就是吐一段抽风的东西回来。
两条约束一叠,就压出了 5.17 秒的画面跑 6 分钟这个比例。
一集 30 个镜头,理论上 3 小时。可实际哪有一次过的?关键帧要重抽,镜头要重跑,夜里挂一整晚、八小时左右出一集,才是常态。
拿短剧的量级折一下:一集 2 分钟、一百集,12000 秒,按这速度光渲染就得 232 小时。这张卡不吃不喝连转十天,而且是一次过的理想值,重抽还没算进去。
232 小时
一百集的纯渲染时间,还没算重抽
8 小时
现实里挂一整夜,出一集
03 RESOLUTION
第二处:41 像素的脸
时间慢归慢,好歹能熬,大不了多挂几个晚上。第二处跟时间没关系,熬多久都不会变。
736×416 这个画面里,一个中景镜头的人脸能占多少像素?41 到 90 px。
41 px
中景人脸,超分之前
86 px
超分之后,还是没有眼神
超分救得回来吗?我用的是 RealESRGAN 的动漫 4x 模型,先超上去,再用 lanczos 降回 1536×832,成片规格就是这么来的。绕这一圈是因为超采样再降采样,边缘比直接放大两倍干净。
踩坑
一开始其实用的是 2x-sudo,后来量了一下,它红通道每帧 +1.7、绿几乎不动,整片肉眼可见地发黄,才换掉的。发黄这种事眼睛第一时间说不清,得去量通道均值才抓得住。
结果有点尴尬。超分确实是往画面里加细节,不是把糊的地方蒙过去,可它加不出原本就不存在的五官。41 px 的脸里没有眼神,超完是一张 86 px 的、依然没有眼神的脸。轮廓是干净了点,五官还是那团东西。
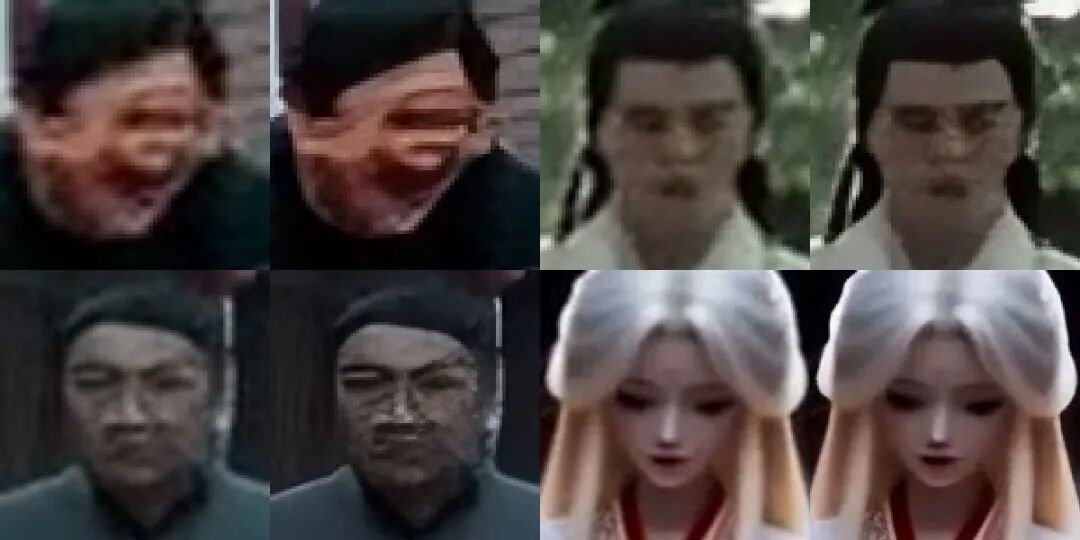
— 四组小脸,每组左边是超分前、右边是超分后。眼镜被拧成两道横杠,五官整个错位
读到这儿大概会想说:那换个简单画风不就完了。这条路我走过。
《狱卒》之前我做过一部写实风的长片,叫《九尾》,58 段接成一部,是这条线上跑得最久、吃 token 最多的一部。最后我自己把它删了:路人的脸全是糊的;主角的脸不稳,同一个角色隔几段就换一副长相。
— 《九尾》
现在回头翻九尾的截图,还能看出更麻烦的一层。随手抽六个镜头,四个在躲脸:极特写只拍一只眼睛,大远景把人缩成一个点,背影,火把挡住的后脑勺。当时我还挺得意,觉得自己在追求某种风格。实际上是脸拍不清楚,反过来在替我挑镜头。等我反应过来,已经默认自己只能这么拍了。
后来换成《狱卒》这种动漫画风,扁平上色,五官靠线条勾,确实好了一截。同样 60 个像素,写实脸是一团分不出五官的肉色,动漫脸至少眼睛和嘴还待在该待的位置上。
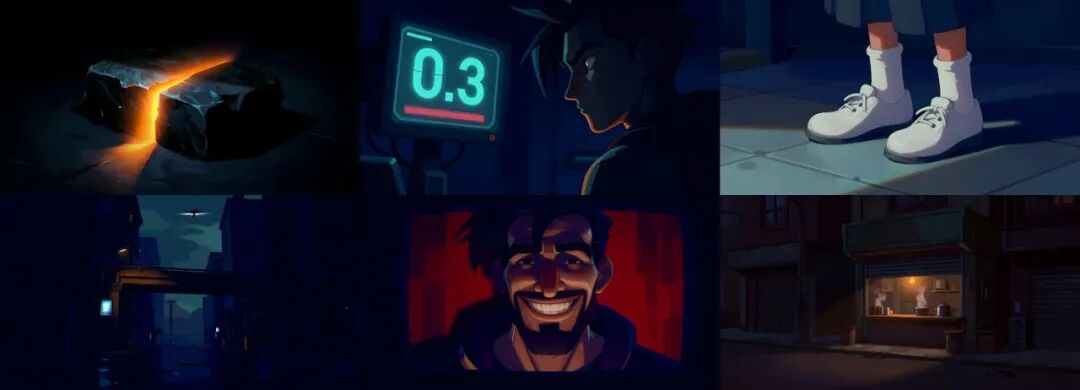
— 《狱卒》:同样的分辨率,动漫画风下五官还立得住
但也就好了一些。60 个像素能装多少信息?
04 LESSONS
那 25 亿到底烧在哪了
前面全是坏消息,这段说点经验。25 亿 token 里绝大部分压根没落到成片上,都用在试错了。
一、想让人物站左边,改提示词是白改的
起因特别朴素:我想让人物站在画面左边。
三种写法都试了:把多余的从句全删光;把 on the left 往最前面压;直接写画幅裁切的指令。然后量人物在成图里的实际水平位置,三种写法影响接近于零。
后来的解法是绕过去。关键帧我用 z-image 出 1280×720,H3 要的是 736×416,两个画幅比例不一样,中间天然留着一条余量。我在 1280×720 里把人摆好,再按 H3 的比例裁一刀,想让人物偏左,就往右边多切一点。
二、检查器上岗之前,先查它误杀多少
夜跑要无人值守,就得有个东西替我判断这张关键帧行不行。于是写了个自动验收:判据从分镜字段反推,分镜里写了「中景、两人、面向左」,脚本就去检人脸数量、人脸框大小、朝向。人脸检测扔 CPU 上跑,不跟 ComfyUI 抢显存。
三、同一镜里状态要变的,关键帧一律画「变化之前」
有个镜头,角色要从站着变成跪下。关键帧我画的是跪下的样子,当时想的是,这就是我要的结果。出来的视频,是他从跪着站了起来。
踩坑
模型把关键帧当起点用。给它一个终态,它就从终态往外演,往哪个方向演基本靠运气。门开着还是关着、灯亮着还是灭着,都是同一回事。
改成画变化之前的站姿,动作写进提示词里,一次就对了。
四、选题:这个世界里的东西,模型见过真的吗
我还做过一组山海经的异兽,30 个镜头,删了 6 个,20%。后来做一组 SCP 题材的,108 个镜头,砸了 2 个,1.9%。差了十倍。我一开始以为是山海经难画,后来发现跟难度真没关系。
山海经异兽
20%
30 镜砸 6 镜
SCP 题材
1.9%
108 镜砸 2 镜
SCP 那边画的是走廊、防护服、金属门、监控画面,全是现实里存在的东西,训练集里躺着海量真实照片,模型清楚标准答案长什么样。山海经的异兽呢?只有历代画师的想象图,画风还互相打架。模型手里没有一个稳定的真实版本,每抽一次都是一次新解读。
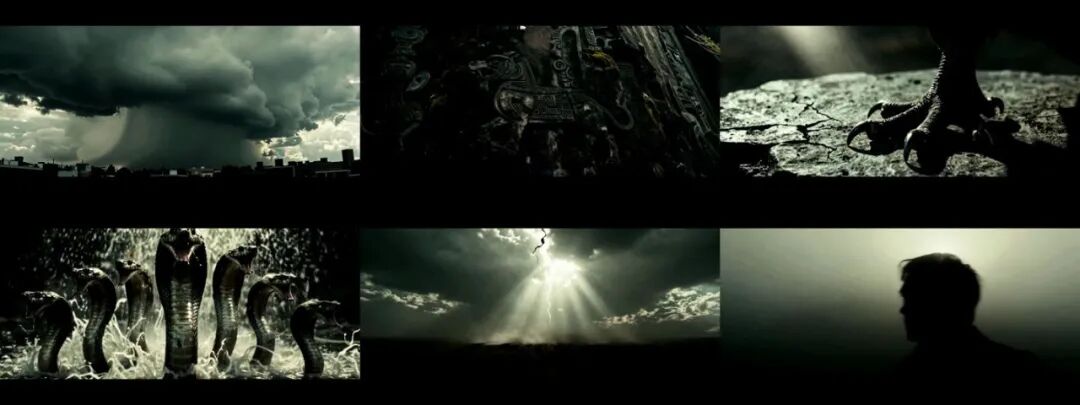
— 《山海》预告片
不过光是真实存在还不够。之前做过一部讲奇形怪状动植物的科普片,里面要一只洞螈,欧洲洞穴里那种没有眼睛、通体粉白、四肢细得像牙签的两栖动物。它当然真实存在,维基百科上就有照片。
抽了三次,三次都给我墨西哥钝口螈,就是被当宠物养的那个六角恐龙:黑眼睛,粗四肢,跟洞螈完全两种生物。加拉丁学名 Proteus anguinus,没用。负向里把 axolotl、宠物、水族箱、大眼睛、粗壮四肢全排除掉,还是没用。
解法
模型对洞螈这个词的理解是焊死的,那个更出名的近亲把词位占走了,提示词里怎么绕都没用。换个说法,写成「洞穴盲鱼」,一次就对。
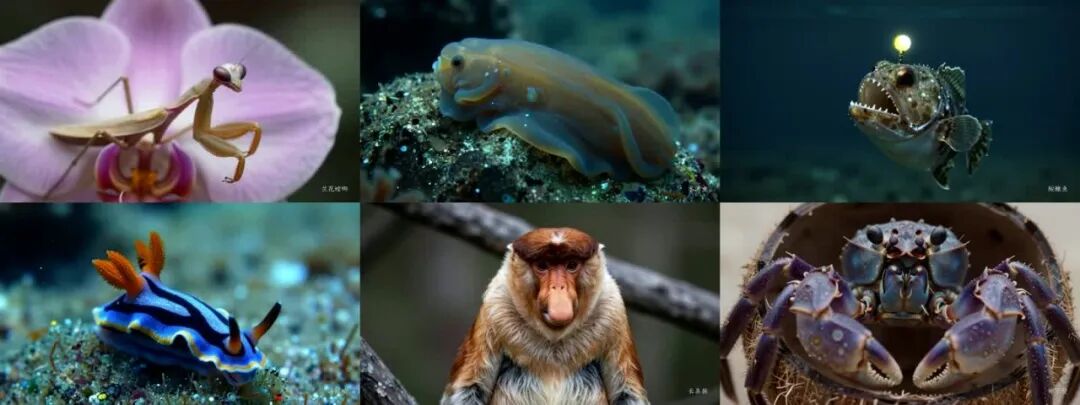
— 同一部片里的其它主角:全是现实中真实存在的怪东西,所以能正确生成
随机的差异靠重抽能磨平,方向一致的错误抽一百次还是那个错。这条判据最实用的地方,是让我十分钟内就能拍板:继续抽,还是改设计。不至于在一个镜头上耗掉一整宿。
其实选题阶段就能省掉一半重抽,挑现实里存在的东西,顺手确认一下这名字没被别的物种占着。
05 LOCAL VS CLOUD
那为什么不干脆上云
H3 图生视频云端官方价 768P 是 0.50 元/秒,我这 181 秒成片全走云端大概 90 元,说实话也不贵。
但是这是一次过的价格。真实重抽倍率按 3 到 5 倍算,两集就是三五百块。
90 元
181 秒成片,一次过的账面价
三五百
把重抽算进去以后的实际价
更要命的还不是这个数。回头看上面那四条:三种写法量出来零效果,检查器整夜误杀,终态关键帧倒着演,山海经砸掉两成,全是白烧掉的。
本地跑这些只烧电,云端上每一次抽风都在扣钱。25 亿 token 大半花在试错上,这笔账搬到云端,我是烧不起的。
本地做探索、云端做交付。反过来先拿云端摸参数,那些失败本来是不要钱的。
所以算下来,我这边的用法就是这样。参数摸清了、分镜定稿了,最后一遍拿去云端跑高分辨率,这钱花得值。
∞ THE END
12G 显存暂时只到这
换 24 GB 就一定行吗?我不敢打包票,但至少有三个地方会同时松开。
1 分辨率能提到 0.5 MP 以上,中景脸从 86 px 变成 112 px,这样超分就能从止损变成增益了。
2 不用每段重启 ComfyUI,每段省掉一次模型重载的固定开销,夜跑的有效产能能往上抬一截。
3 文本编码器也不用再降级成 GGUF,内存也就不再是第二个瓶颈,现在 31.2/32 同样吃满。
我觉得第一条最要紧。它不是快一点慢一点的事,是超分这一步到底能不能帮上忙。
方法论全放 GitHub 了,github.com/L-Trunks/ai-film-skills,MIT + CC-BY,六个 skill,1600 多行踩坑记录。上面写的四条只是其中一部分,长短镜族的区分、后期链的顺序、导演手册里那套轴线和视线匹配,都在里面。
END
关于作者
我是阿麦,专注各模型本地部署与喂饭式科普。
这篇要是有用,欢迎点赞、在看、转发三连,我们下篇见。